링크드인의 데이터 컨텍스트 레이어
링크드인이 사람과 AI 에이전트를 위해 만든 데이터 컨텍스트 레이어를 정리했습니다. 자동 생성과 사람의 큐레이션을 합치는 구조, 인덱스 트리, 성과, 핀터레스트 지표 레이어와의 비교를 다뤘습니다.
목차
들어가며
결론부터: 데이터 질문에 답하는 데 오래 걸리는 건 쿼리 작성이 아니라 맞는 데이터셋을 찾고 올바르게 쓰는 법을 아는 일이다. 링크드인은 2026년 10월 9일 공개한 글 Inside LinkedIn’s data context layer에서 이 문제를 이렇게 설명한다.
The query may take a minute to write, but identifying the right datasets, applying the required filters, and understanding what each row represents can take a whole day before getting to the result you can trust.
“지난주 새 기능을 쓴 회원이 몇 명인가?” 같은 질문은 쿼리 작성에 1분이면 된다. 하지만 비슷한 이름의 데이터셋 중 무엇을 써야 하는지, 어떤 필터를 반드시 걸어야 하는지, 각 행이 무엇을 뜻하는지 알아내는 데 하루가 걸릴 수 있다. 에이전트는 더 위험하다. “AI agents can write syntactically correct SQL in seconds, yet confidently select the wrong dataset or miss a required filter.”
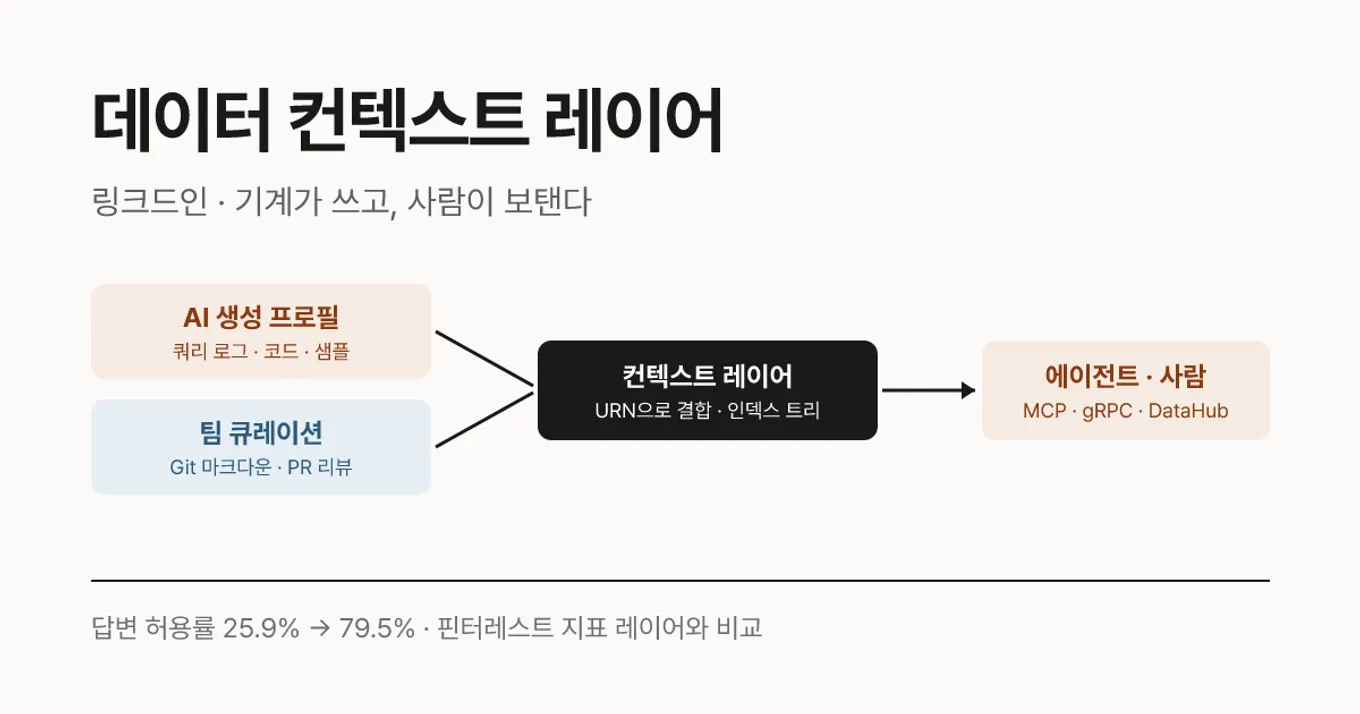
링크드인은 이 문제를 데이터 컨텍스트 레이어로 풀었고, 한 비즈니스 영역 벤치마크에서 에이전트의 허용 가능 답변 비율이 25.9%에서 79.5%로 올랐다. 이틀 전에 정리한 핀터레스트 Metrics Board가 지표를 다뤘다면, 링크드인은 데이터셋을 다룬다. 이 글에서는 원문과 다이어그램 9개를 바탕으로 구조를 정리하고, 두 회사를 비교한다.
두 갈래의 컨텍스트: 기계가 쓰고, 사람이 보탠다
링크드인의 컨텍스트 레이어는 두 갈래에서 온다. 원문 다이어그램의 한 줄이 핵심이다. “every asset gets a generated baseline; people add what no machine can infer.”
| 자동 생성 | 사람의 큐레이션 | |
|---|---|---|
| 쓰는 주체 | AI 보강 파이프라인 | 데이터를 소유하고 쓰는 팀 |
| 범위 | 등록된 모든 자산에 자동으로 | 팀이 지침을 보탠 곳 |
| 갱신 | 파이프라인이 다시 생성 | 리뷰를 거친 Pull Request로 |
| 예시 | “각 행은 하루당 작업 1건, 보통 job_id로 조인” | “과거 데이터 누락, 마이그레이션 백필이 돌지 않았음” |
왜 둘 다 필요할까. 데이터셋이 수백만 개라 사람이 다 문서화하는 건 불가능하고(“manually documenting millions of datasets is impractical”), 사람이 쓴 문서는 전체를 덮지 못하고 금방 낡는다. 반대로 자동으로 모은 신호는 팀이 아는 것을 다 담지 못한다. 예를 들어 “이 지표는 참여 리포트에는 맞지만 재무 결산에는 쓰면 안 된다”, “이 조인 키는 특정 날짜 이후 데이터에만 유효하다” 같은 지식은 기계가 추론할 수 없다.
자동 생성: 실제로 어떻게 쓰이는지에서 배운다
생성 파이프라인은 네 단계다.
- 선정: 비즈니스 중요도, 조직 간 공유, 핵심 대시보드 사용 같은 카탈로그 라벨로 대상 데이터셋을 자동으로 고른다. 팀이 직접 요청할 수도 있다.
- 수집: 마스킹된 샘플 데이터, 쿼리 로그, 컬럼·지표 사용 이력, 소스 코드, 위키 정의를 모은다.
- 생성: LLM이 이 신호들로 데이터셋 프로필(목적, 필드, 조인 키, 대표 쿼리)을 만든다.
- 저장: 컨텍스트 레이어에 저장하고 의미 검색용 임베딩도 만든다.
가장 흥미로운 건 쿼리 로그를 읽는 방법이다. 스키마만 봐서는 알 수 없는 “쓰이지 않는 규칙”이 있다. 중복 집계를 피하려고 반드시 거는 파티션 필터, 특정 조인 키 같은 것들이다. 링크드인은 쿼리를 정규화해서 이 패턴을 찾는다.
-- 서로 다른 쿼리 수천 개WHERE dt = '2026-03-01' AND id IN (7, 9)WHERE dt = '2026-03-02' AND id IN (4)WHERE dt = '2026-03-03' AND id IN (2, 8, 1)
-- 주석 제거, 리터럴 마스킹, IN 목록 접기, 공백 정리 → 같은 모양 하나로WHERE dt = ? AND id IN (?)
이렇게 묶은 패턴을 실행 횟수로 줄 세우면, 사람들이 실제로 의존하는 조인과 필터가 드러난다. 에이전트에게는 “job_id로 조인하고, 항상 datepartition으로 필터하라” 같은 형태로 전달된다. 원문 다이어그램의 문구가 이걸 요약한다. “Ten thousand queries, one pattern.” 대시보드가 만든 자동 쿼리와 사람이 직접 쓴 쿼리도 구분하고, 쿼리 로그에 잘 안 잡히는 파이프라인용 데이터셋은 Spark·Airflow·dbt 소스 코드를 뒤져 보완한다.
샘플 값도 쓴다. 문자열 필드가 비즈니스 카테고리인지, 날짜 형식인지, 식별자인지는 값 몇 개를 보면 바로 알 수 있다. 기본으로 5행을 가져오되, 테이블 크기, 컴플라이언스 표기, 기밀 등급, 값의 고유성 비율을 차례로 확인해 하나라도 걸리면 값을 가린 뒤에야 모델에 넣는다.
사람의 큐레이션: 컨텍스트를 코드처럼
사람이 쓰는 컨텍스트는 Git 저장소의 마크다운 파일로 관리한다. 팀이 지식을 마크다운으로 쓰고 PR을 열면, 데이터 소유자가 코드 리뷰처럼 승인한다. 자동 검사가 누락이나 중복을 리뷰 전에 잡는다. 원문의 표현으로 “Asset owners approve curated context as they would code changes.”
소유 범위는 세 단계다.
- Global: 회사 전체가 공유하는 데이터셋과 지표의 공식 정의. 카탈로그의 데이터 소유자가 책임진다.
- Team: 팀의 운영 지식. 플레이북, 알려진 문제, 도메인 정의, 팀이 소유한 데이터셋·지표 메모.
- Analysis: 특정 질문에 답한 인증된 분석. 핵심 결론을 맨 앞에 두고 방법론, 가정, 데이터 출처, 쿼리를 붙인다. 작성자와 날짜가 있고 동료 리뷰를 거친다. “so a past answer is reusable instead of stranded in a chat thread.” 채팅방에 묻혀 사라지던 과거의 답을 다시 쓸 수 있는 자산으로 만든다.
팀 폴더는 모두 같은 구조를 따른다. 그중에는 에이전트를 위한 가드레일만 따로 적는 폴더도 있다.
{팀}/team/ team_overview/ 팀의 역할과 미션 domain_knowledge/ 의미 정의, 스키마 문서 playbooks/ 운영 런북 known_issues/ 데이터 품질 주의사항, 함정 agent_guidelines/ AI 에이전트용 가드레일 datasets/ 데이터셋별 메모 metrics/ 지표별 메모 index.json 자동 생성, 직접 수정 금지설계에서 중요한 선택이 하나 있다. 자동 생성본과 사람이 쓴 것을 따로 저장한다. 파이프라인이 다시 돌아도 사람이 적은 수정, 예외, 사용 지침을 덮어쓰지 않게 하기 위해서다. 둘은 같은 자산 식별자(URN)로 묶여 있어서, 조회할 때는 한 번에 합쳐서 돌려준다. 그리고 사람의 수정은 생성 파이프라인의 빈틈을 알려주는 피드백이 된다.
에이전트가 읽는 법: 인덱스 트리와 점진적 공개
컨텍스트를 잘 쌓아도 에이전트가 전부 읽으면 소용없다. 원문은 이렇게 쓴다. “Without an index, it would have to read every file to determine what is relevant, quickly filling its context window and reducing both efficiency and answer quality.”
그래서 링크드인은 컨텍스트를 인덱스 트리로 정리했다. 각 마크다운 파일에는 한두 문장짜리 요약(summary)이 붙고, 이 요약들이 아래에서 위로 모여 섹션, 팀, 조직, 저장소 단위의 인덱스가 된다.
| 단계 | 담는 것 |
|---|---|
| 저장소 인덱스 | 조직별 요약 |
| 조직 인덱스 | 팀별 요약 |
| 팀 인덱스 | 섹션별 요약 |
| 섹션 인덱스 | 파일별 미리보기 |
| 문서 | 필요할 때만 전체 내용을 가져옴 |
에이전트는 위에서부터 요약만 읽으며 관련 있는 가지를 따라 내려간다. 매출 질문이라면 저장소 요약에서 조직을 고르고, 팀과 지표 섹션을 거쳐, 네 번의 인덱스 읽기로 필요한 문서 하나에 도착한다. 관련 없는 문서는 하나도 불러오지 않는다. 컨텍스트 엔지니어링에서 다룬 SELECT와 OFFLOAD를 그대로 구현한 구조다. 정보는 창 밖에 두고, 지금 필요한 것만 골라서 가져온다.
같은 컨텍스트를 세 경로로 서빙한다. 에이전트는 MCP 도구로(자산 검색, 컨텍스트 조회, 인덱스 탐색), 애플리케이션은 gRPC API로, 직원은 DataHub(데이터 카탈로그)에서 본다. 핵심은 지식을 한 곳에서만 관리한다는 점이다. “Authors maintain the knowledge in one place rather than copying it into separate agent configurations or prompts.” 팀마다 에이전트 프롬프트에 지식을 복사해 넣으면 금방 서로 어긋난다. 실제로 각자 컨텍스트 레이어를 만들던 팀들이 이 공유 레이어로 통합했다고 한다. PR 브랜치에 있는 초안 컨텍스트로 에이전트를 미리 시험해 볼 수 있는 것도 실용적인 장치다.
성과와 한계
원문에 공개된 성과는 두 가지다.
| 항목 | 이전 | 이후 |
|---|---|---|
| 허용 가능 답변 비율 (한 비즈니스 영역 벤치마크, 권한 보정) | 25.9% | 79.5% |
| 질문 하나에 답하는 시간 (중앙값) | 10.7분 | 4.7분 |
정답률이 세 배 가까이 오르고 시간은 절반 이하로 줄었다. 다만 원문 스스로 “Early evaluations”이고 “suggest potential benefits”라고 조심스럽게 표현한다. 벤치마크 문항 수, 어떤 비즈니스 영역인지, “허용 가능”과 “권한 보정”의 정의, 누가 채점했는지는 공개되지 않았다. 한 영역의 초기 결과라는 점을 감안하고 읽는 게 맞다.
한계도 원문에 담겨 있다. 생성 프로필은 등록된 자산에만 적용되고, 사람이 쓴 컨텍스트는 여전히 일부만 덮는다. 그리고 이렇게 정리한다. “Authoring context is only part of the work, because its value depends on whether people and agents can find and apply it correctly.” 그래서 다음 과제로 검색, 평가, 에이전트 연동을 함께 개선하겠다고 했다.
핀터레스트 Metrics Board와 무엇이 다른가
같은 주에 공개된 두 글은 같은 문제를 다른 층에서 푼다.
| 핀터레스트 Metrics Board | 링크드인 데이터 컨텍스트 레이어 | |
|---|---|---|
| 다루는 대상 | 지표 (계산 결과) | 데이터셋 (원재료) |
| 정의의 형태 | 지표마다 YAML 스펙 (SQL, 시간 컬럼, 검증 규칙) | 데이터셋마다 생성 프로필 + 마크다운 큐레이션 |
| 자동화하는 것 | 계산 파이프라인, 품질 검증, 도구 배포 | 쿼리 로그·코드·샘플에서 사용법 추출 |
| 사람의 역할 | 지표 정의를 쓰고 등급을 올림 | 생성본이 놓친 예외와 맥락을 보탬 |
| 신뢰 신호 | 지표 등급 (Unknown~A+), 대시보드 티어 | 소유자 리뷰, 인증된 분석(Analysis) |
| 에이전트 접근 | MCP 서버, 인증된 지표와 정답 쿼리 참조 | MCP 도구, 인덱스 트리로 점진적 탐색 |
| 관리 방식 | Git + PR | Git + PR |
차이를 한 문장으로 하면 이렇다. 핀터레스트는 “무엇을 셀지”를 고정하고, 링크드인은 “무엇으로 셀지”를 설명한다. 에이전트가 “활성 사용자”를 물으면 핀터레스트는 공식 지표를 그대로 가져다 쓰게 하고, 링크드인은 그 지표를 만들 데이터셋을 고르고 올바르게 쓰는 법을 알려준다. 지표로 정의되지 않은 새로운 질문일수록 링크드인 방식이 필요하고, 같은 질문이 반복될수록 핀터레스트 방식이 효율적이다. 결국 둘은 경쟁이 아니라 한 회사 안에서 함께 필요한 층이다.
그리고 공통점이 더 중요하다.
- 두 회사 모두 “Git + PR”을 택했다. 데이터 지식을 위키가 아니라 코드처럼 리뷰하고 버전 관리한다.
- 두 회사 모두 사람을 위한 신뢰 작업이 에이전트의 기반이 됐다. 핀터레스트는 “the work we did to make metrics trustworthy for humans is what makes them usable by agents”라고 했고, 링크드인도 같은 레이어를 사람(DataHub)과 에이전트(MCP)에 함께 서빙한다.
- 두 회사 모두 판단을 없애려는 게 아니다. 링크드인의 마지막 문장이 그렇다. “The goal is not to eliminate judgment, but to make the knowledge behind it easier to find, reuse, and improve.”
데이터 팀의 LLM 활용 사례를 조사하며 본 공통 교훈, “성패는 모델이 아니라 테이블과 정의가 가른다”를 가장 체계적으로 구현한 두 사례인 셈이다.
마치며: 작은 팀이 가져올 것
링크드인 규모가 아니어도 가져올 만한 것들을 정리해 본다. 아래는 원문을 바탕으로 한 내 정리다.
- 쿼리 로그부터 읽는다. 문서를 새로 쓰기 전에, 가장 많이 실행된 쿼리 패턴 상위 몇 개를 뽑아 보면 실제로 쓰이는 조인 키와 필터가 보인다. 리터럴만 가려서 묶어도 충분히 의미 있는 결과가 나온다.
- “알려진 문제” 문서를 따로 둔다. 누락된 기간, 백필이 안 된 구간, 쓰면 안 되는 용도. 이런 주의사항은 스키마 설명보다 오답을 더 많이 막는다.
- 좋은 분석은 재사용 가능한 자산으로 남긴다. 결론, 방법, 가정, 쿼리를 한 문서로 묶고 날짜와 작성자를 붙이면, 채팅방에 묻히던 답이 다음 질문의 출발점이 된다.
- 요약을 붙이고 인덱스를 만든다. 문서마다 한두 문장 요약을 붙이고 그 요약들로 목차를 만들면, 사람도 에이전트도 전체를 읽지 않고 필요한 곳으로 바로 간다. 사실 Claude Code의 메모리도 같은 방식이다. 한 줄짜리 색인 파일을 먼저 읽고, 필요한 메모만 열어 본다.
- 기계가 쓴 것과 사람이 쓴 것을 분리한다. 자동 생성 문서를 사람이 직접 고치면 다음 생성 때 덮어써진다. 사람의 수정은 별도 파일로 두고 조회할 때 합친다.