컨텍스트 엔지니어링: 많이보다 맞게
컨텍스트 엔지니어링은 LLM에 더 많은 정보가 아니라 맞는 정보를 주는 기술입니다. 컨텍스트가 길수록 성능이 떨어지는 이유와 SELECT·COMPRESS·TRIM 등 6가지 방법을 정리했습니다.
목차
들어가며
결론부터: AI에게 필요한 건 더 많은 컨텍스트가 아니라 맞는 컨텍스트다. 그 “맞는 것”을 고르고, 줄이고, 배치하는 일을 컨텍스트 엔지니어링이라고 부른다.
이 글은 X에서 본 게시물 하나에서 시작했다. AI 엔지니어 Vikas Gupta(@vicky_grok)가 2026년 10월 5일에 올린 15초짜리 인포그래픽 영상인데, 첫 문장이 이렇다.
YOUR AI DOESN’T NEED MORE CONTEXT. IT NEEDS THE RIGHT CONTEXT. Giving an LLM a 200-page document doesn’t guarantee it will find the one sentence that matters.
200쪽짜리 문서를 통째로 넣는다고 모델이 중요한 한 문장을 찾아낸다는 보장은 없다. 토큰이 많다고 답이 좋아지지 않는다. 이 글에서는 그 게시물의 내용을 뼈대로, 왜 그런지 근거가 되는 연구와 실무에서 쓰는 방법을 정리했다.
컨텍스트 엔지니어링이란
컨텍스트(context)는 모델이 답을 만들 때 볼 수 있는 모든 것이다. 사용자가 쓴 프롬프트만이 아니라 시스템 프롬프트, 도구 설명, 검색으로 가져온 문서, 이전 대화, 메모리가 전부 컨텍스트 창(context window) 하나에 함께 들어간다.
Andrej Karpathy는 컨텍스트 엔지니어링을 “다음 단계에 딱 맞는 정보로 컨텍스트 창을 채우는 섬세한 기술이자 과학”이라고 표현했다(LangChain 블로그에서 재인용). Anthropic은 2025년 9월 글 Effective context engineering for AI agents에서 이렇게 정의한다.
LLM이 추론하는 동안 최적의 토큰(정보) 집합을 고르고 유지하는 전략들. 프롬프트 바깥에서 들어오는 모든 정보를 포함한다.
원 게시물의 마지막 문장이 둘의 차이를 잘 요약한다.
| 프롬프트 엔지니어링 | 컨텍스트 엔지니어링 | |
|---|---|---|
| 다루는 것 | 지시문(어떻게 말할까) | 모델이 볼 수 있는 정보 전체(무엇을 보여줄까) |
| 단위 | 프롬프트 한 번 | 여러 턴, 여러 도구 호출에 걸친 상태 |
| 중요해지는 때 | 단발성 질문 | 몇 시간씩 돌며 도구를 여러 개 쓰는 에이전트 |
프롬프트를 아무리 잘 써도, 그 옆에 쓸모없는 문서 50개와 낡은 대화 40턴이 붙어 있으면 모델은 엉뚱한 곳을 본다. 그래서 에이전트가 길게 일할수록 “무엇을 보여줄지”가 “어떻게 말할지”보다 결과를 더 크게 좌우한다.
왜 많이 넣을수록 나빠지나
“창이 100만 토큰이면 다 넣으면 되지 않나?”라는 질문에 대한 답은 연구로 꽤 정리돼 있다.
1. 길어질수록 정확도가 떨어진다 (Context Rot). Chroma의 2025년 7월 리포트 Context Rot는 단순한 작업에서도 입력 길이가 바뀌면 성능이 크게 달라지고, 모델이 컨텍스트를 균일하게 쓰지 않아 입력이 길수록 결과를 믿기 어려워진다고 보고했다. Anthropic도 같은 현상을 짚으며 LLM에는 사람의 작업 기억처럼 한정된 **주의 예산(attention budget)**이 있고, 토큰 하나하나가 그 예산을 깎는다고 설명한다.
2. 가운데는 잘 안 본다 (Lost in the Middle). Liu 외(2023)의 Lost in the Middle은 관련 정보가 입력의 처음이나 끝에 있을 때 성능이 가장 높고, 가운데 있을 때 크게 떨어진다는 것을 보였다. 원 게시물의 영상은 이걸 U자 곡선으로 그리고 가운데를 “DEAD ZONE”이라고 불렀다.
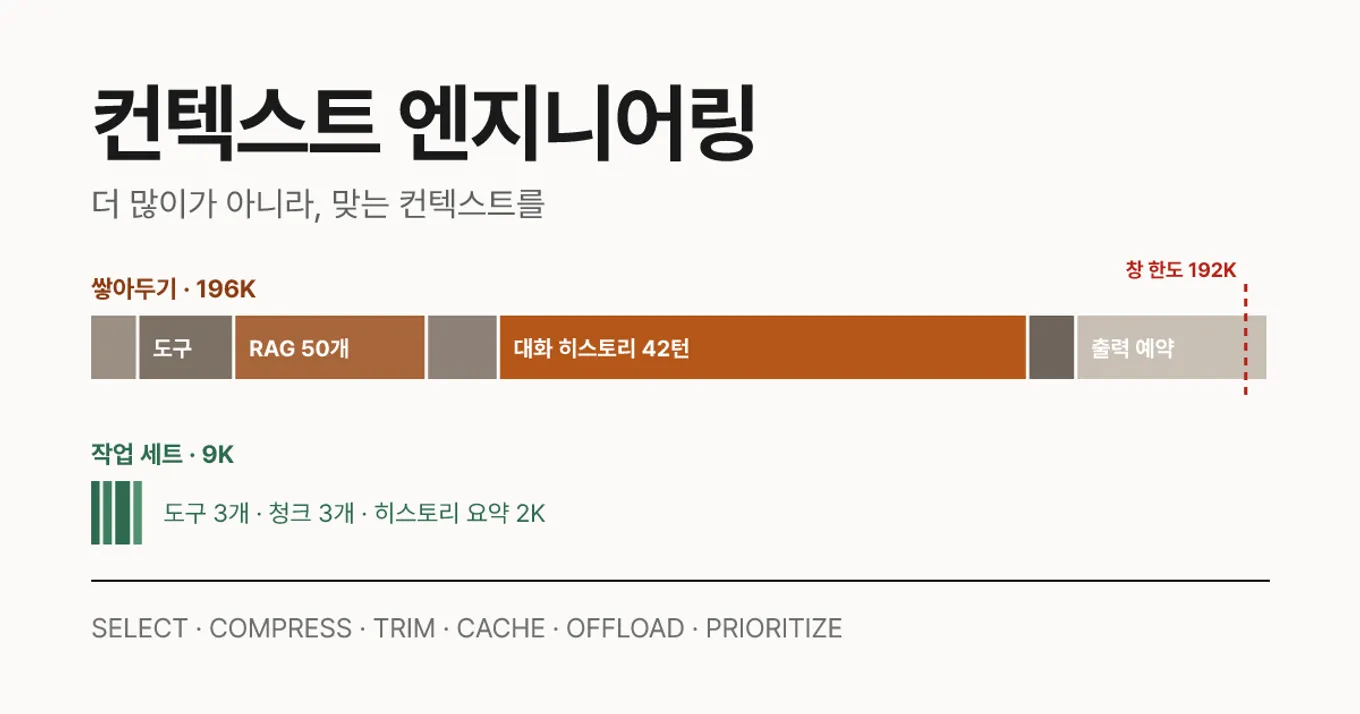
3. 생각보다 창이 금방 찬다. 영상에 나온 예시 계산이 직관적이다. 192K 창에 에이전트 한 턴이 이렇게 들어간다.
| 구성 요소 | 토큰 | 비고 |
|---|---|---|
| 시스템 프롬프트 | 8K | |
| 도구 스키마 | 16K | 도구 40개를 매 턴 전부 로드 |
| RAG 컨텍스트 | 32K | 정렬 안 된 검색 결과 50개 |
| 메모리 | 12K | |
| 대화 히스토리 | 88K | 42턴, 매 턴 늘어남 |
| 사용자 질문 | 8K | |
| 출력 예약 | 32K | |
| 합계 | 196K | 한도 192K를 4K 초과 |
답을 쓰기도 전에 대화 히스토리 하나가 창의 절반 가까이를 먹는다. 그리고 이렇게 꽉 채운 상태가 1번과 2번 문제를 동시에 키운다.
맞는 컨텍스트를 만드는 6가지 방법
원 게시물은 해법을 6개의 동사로 정리했다. 영상에서는 이걸 “가벼운 컨텍스트를 위한 레버”라고 불렀다.
| 방법 | 하는 일 | 예시 |
|---|---|---|
| SELECT | 이번 작업에 필요한 것만 가져온다 | 검색 결과 50개 → 재정렬(rerank) 후 상위 3개 |
| COMPRESS | 긴 기록을 쓸모 있는 요약으로 바꾼다 | 대화 42턴(88K) → summary.md 2K |
| TRIM | 관련 없는 지시와 낡은 정보를 걷어낸다 | 도구 40개 스키마 → 이번 작업에 쓸 3개만 |
| CACHE | 재사용할 컨텍스트를 준비해 둔다 | 시스템 프롬프트 같은 고정 앞부분을 프롬프트 캐시로 |
| OFFLOAD | 정보를 바깥에 두고 필요할 때 다시 읽는다 | 사실·결정 사항을 파일에 적고 나중에 읽기 |
| PRIORITIZE | 중요한 지시와 근거를 모델이 잘 보는 자리에 둔다 | 핵심 문서를 처음과 끝에 배치 |
영상은 이 방법을 적용한 결과를 “메모리 누수 vs 작업 세트”로 비교한다. 히스토리를 그대로 들고 정렬 안 된 청크 50개와 도구 40개를 매 턴 싣는 쪽은 94K, 적용한 쪽은 9K다. 토큰이 약 90% 줄고, 답은 근거가 분명해지고 빨라지고 싸진다는 주장이다.
다른 곳에서도 비슷한 분류를 쓴다. LangChain은 WRITE(창 밖에 저장)·SELECT(창 안으로 가져오기)·COMPRESS(필요한 토큰만 남기기)·ISOLATE(나눠서 맡기기) 네 가지로 나누고, Anthropic은 압축(compaction), 구조화된 메모(structured note-taking), 서브에이전트, 필요할 때 가져오기(just-in-time retrieval)를 든다. 이름은 달라도 핵심은 같다. 창 안에는 지금 필요한 것만 두고, 나머지는 밖에 두되 다시 찾을 수 있게 한다.
요약은 공짜가 아니다
이 게시물 답글에서 가장 좋았던 지적은 COMPRESS에 대한 것이었다. 요약은 “나중에 무엇이 중요해질지”를 지금 미리 정해버린다. 소설 2장에 나온 약속이 9장에서 핵심이 되는 것처럼, 요약할 때 버린 디테일이 나중에 필요해질 수 있다. 그래서 장기 작업에서는 대화 전체를 한 덩어리로 요약하기보다 결정, 약속, 규칙처럼 성격이 다른 정보를 따로 보관하는 편이 안전하다.
또 하나는 “맞는 컨텍스트”가 턴마다 바뀐다는 점이다. 1턴에 맞던 문서가 사용자의 요구가 바뀐 5턴에는 방해가 된다. 한 번 잘 골라 두는 것으로 끝나지 않고, 대화가 진행되는 동안 계속 고쳐야 한다.
이 블로그의 예: 아침 글감 브리핑
사실 이 글의 소재도 컨텍스트 엔지니어링으로 만든 파이프라인에서 나왔다. 매일 아침 Claude Code가 Aside 브라우저로 뉴스 사이트와 X·Threads를 훑고, 블로그 글감 후보를 디스코드로 보내 준다. 여기에 위 방법들이 그대로 들어가 있다.
- SELECT: 키워드 파일에서 data·ai 카테고리 행만 읽게 한다. 여행 키워드는 이 작업에 필요 없다.
- TRIM: 에이전트에게 허용하는 도구를 브라우저 실행, 메모리 검색, 파일 읽기용 5개로 제한한다. 쓰지 않을 도구 설명은 컨텍스트에 아예 올라가지 않는다.
- OFFLOAD: 이미 보낸 URL 목록과 날짜별 브리핑 원문을 파일로 남긴다. 다음 날 실행은 이 목록만 보고 중복을 거르고, “어제 브리핑 3번 리서치해줘” 같은 후속 작업은 그 날짜 파일만 읽는다.
- PRIORITIZE: 수집 순서와 출력 형식은 프롬프트 앞쪽에 두고, 매일 바뀌는 오늘 날짜와 제외할 URL 목록은 맨 끝에 붙인다.
효과는 측정으로 확인한다
컨텍스트를 줄이면 비용과 속도는 확실히 좋아진다. 문제는 답의 품질이다. 영상의 “토큰 90% 감소”는 예시 계산이지 측정 결과가 아니다. 히스토리를 요약했더니 정답률이 떨어졌다면 줄인 의미가 없다.
그래서 컨텍스트 전략을 바꿀 때는 실험처럼 다루는 게 맞다. 주요 지표는 비용이나 지연 시간이고, 정답률이나 작업 완료율은 떨어지면 안 되는 가드레일 지표다. “정답률이 유의하게 떨어지지 않았다”가 아니라 “정해 둔 마진 이상 떨어지지 않았다”를 확인해야 한다는 점은 A/B 테스트 가드레일 지표와 비열등성 검정에서 다룬 내용 그대로다. 평가 세트가 그 차이를 잡아낼 만큼 충분한지는 검정력 분석으로 미리 확인한다.
마치며
- 컨텍스트 엔지니어링은 모델에게 무엇을 보여줄지 설계하는 일이다. 프롬프트가 지시를 다듬는다면 컨텍스트는 정보를 다듬는다.
- 컨텍스트가 길수록 정확도가 떨어지고(Context Rot), 가운데 정보는 묻힌다(Lost in the Middle). 큰 창은 다 채우라고 있는 게 아니다.
- SELECT·COMPRESS·TRIM·CACHE·OFFLOAD·PRIORITIZE로 창 안에는 지금 필요한 것만 두고, 나머지는 밖에 두되 다시 찾을 수 있게 한다. 요약은 정보를 잃는다는 점을 기억한다.
- 컨텍스트를 줄인 효과는 품질 가드레일과 함께 측정해서 확인한다.
컨텍스트 엔지니어링을 찾아보다 보면 AX라는 말도 자주 만난다. 같은 약어가 한국과 해외 개발자 커뮤니티에서 전혀 다른 뜻으로 쓰이는데, 다음 글 AX 뜻: AI 전환과 Agent Experience에서 정리했다.