데이터 문해력: 결과가 나왔다고 끝난 것은 아니다
『데이터 문해력』 4장 원인 파악 능력을 정리했습니다. 데이터 원인 분석의 순서(원인 후보, 지표, 관련성 확인)와 상관관계를 인과관계로 착각한 실제 사례, 내 블로그에 적용한 결과를 다룹니다.
목차
들어가며
결론부터: 데이터 원인 분석의 끝은 리포트가 아니라 행동이다. 『데이터 문해력』 4장 “원인 파악 능력”은 데이터를 정리해 결과를 냈다고 일이 끝난 게 아니라고 말한다. 결과를 만든 원인을 찾고, 그 원인에 맞는 행동까지 이어져야 한다.
데이터 문해력 2장 정리에서 책의 데이터 활용 프로세스를 소개했다.
목적·문제 정의 → 지표 결정 → 현재 상태 파악 → 평가 → 요인 분석 → 해결 방안 모색2장이 앞의 두 칸이었다면, 4장은 뒤의 두 칸인 요인 분석과 해결 방안 모색이다. 이 글은 4장을 세 부분으로 나눠 정리한다.
- 왜 원인까지 가야 하는가
- 데이터에서 원인을 찾는 순서
- 원인을 찾을 때 빠지기 쉬운 함정 네 가지
각 부분에 실제 기업·연구 사례를 붙였고, 마지막에는 2장 글에서 세운 내 블로그의 원인 후보에 4장의 방법을 대 봤다.
최종 목표는 행동과 판단이다
데이터 정리에서 멈추는 경우
분석 리포트가 “이번 달 매출은 지난달보다 8% 줄었습니다”로 끝나는 경우가 많다. 책은 이런 상태를 목적에 이르지 못한 어중간한 상태라고 본다. 결론으로 이어지지 않는 정보는 가치가 별로 없다. 읽는 사람은 “그래서 무엇을 하자는 건가”를 다시 물어야 한다.
해결 방안은 원인을 향해야 한다
“최근 매출이 떨어졌다”는 문제가 있다고 하자. 원래 순서는 매출이 떨어진 원인을 분석하고, 그 원인을 해결할 방안과 행동을 제안하는 것이다. 원인을 건너뛰고 할인 쿠폰이나 광고부터 늘리면, 겉으로 드러난 현상에만 대처하게 된다.
책은 여기서 한 걸음 더 나간다. 자원과 시간은 한정돼 있다. “아무것도 안 하는 것보다 낫다”는 수준으로 세운 대책이라면 차라리 안 하는 게 낫다. 효과가 있을 법한 방법을 객관적으로 검토하고, 거기에 집중해서 비용 대비 효과를 키우는 게 가장 중요하다.
사례: 토스뱅크는 원인에 맞춘 두 번째 대책으로 성과를 냈다
토스뱅크의 “매달 이자만 갚기” 기능은 기대 전환율이 10% 이상이었지만, 오픈 첫날 진입부터 실행까지의 전환율은 2%였다. 팀은 로그만으로는 원인을 알 수 없어서 이탈 시점 설문과 사용성 테스트(UT)를 했고, 원인 두 가지를 찾았다. 상품의 가치가 전달되지 않았다는 것, 그리고 “1년 뒤 대출 연장이 안 될 것 같다”는 불안이었다(토스 채용 아티클, 2024-03-22).
첫 대응으로 튜토리얼을 넣는 실험을 했지만 통계적으로 유의한 차이가 없었다. 두 번째로는 두 번째 원인인 불안을 직접 겨냥해 문구를 “최대 10년 무조건 대출 연장 보장”으로 바꿨다. 그러자 대출 실행률이 29%에서 33%로 약 4%p 올랐고, 건당 실행 금액도 약 200만 원 늘었다. 같은 문제라도 어떤 원인을 겨냥하느냐에 따라 결과가 갈렸다. (참고로 2%는 진입부터 실행까지의 전환율이고 29%→33%는 대출 실행률이라, 기준이 달라 두 숫자를 직접 비교하면 안 된다.)
데이터에서 원인을 찾는 순서
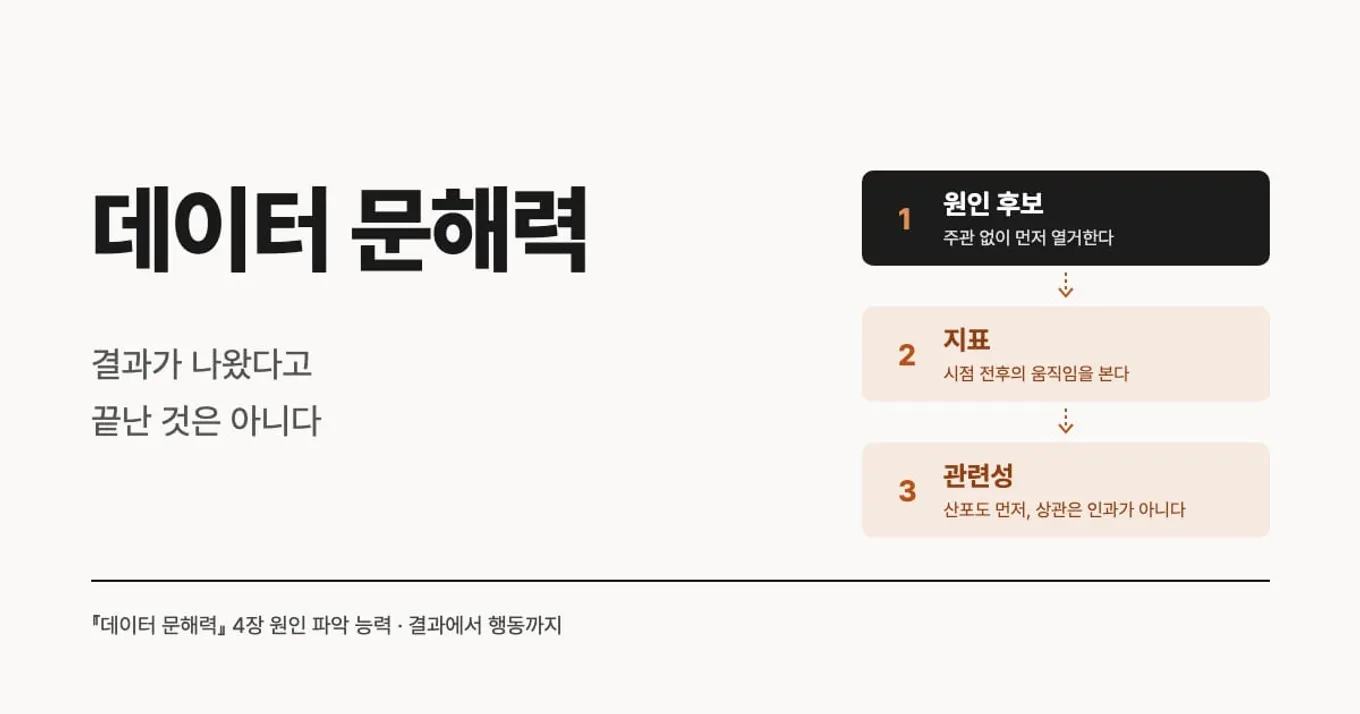
책이 제시하는 순서는 세 단계다.
원인 후보를 열거한다 → 지표를 정한다 → 관련성을 확인한다1단계: 원인 후보를 열거하고, 후보마다 지표를 정한다
책의 예시를 따라가 보자.
| 구분 | 내용 |
|---|---|
| 문제 | 어떤 상품의 매출이 감소했다 |
| 원인 후보 | 경쟁사가 가격 인하 전략을 시작했다 |
| 지표 | 경쟁사의 가격 인하율 변화 |
여기서 중요한 태도가 있다. “이게 정말일까?”나 “당연히 이거지” 하고 후보를 주관적으로 걸러 내지 않는다. 일단 열거하고, 데이터로 판단한다.
지표를 정할 때는 “움직임”을 비교할 수 있어야 한다. 가격 인하라는 움직임과 매출 감소라는 움직임 사이의 관련성을 보려면, 두 현상이 생긴 시점 전후의 변화를 알아야 한다. 그래서 원인 후보가 “경쟁사가 가격을 한 번이 아니라 여러 번 바꾸고 있다”로 구체화되면, 지표도 한 시점의 인하율이 아니라 가격 변동률의 시계열로 바뀐다.
데이터를 구하기 어려울 때
원인 후보는 세웠는데 지표 데이터가 없을 수 있다. 책은 네 가지 대응을 순서대로 제시한다.
- 비슷한 데이터를 찾는다. 직접 지표가 없으면 대신 쓸 만한 지표를 생각한다.
- 지금 바로 수집을 시작한다. 당장은 못 써도 다음 분석에는 쓸 수 있다.
- 정량 대신 정성 정보로 대응한다. 인터뷰, 설문, 관찰 같은 방법이다.
- 포기한다. 그 후보는 검증하지 않고 넘어간다.
앞의 토스뱅크 사례가 3번이다. 로그로 원인을 알 수 없자 설문과 UT로 원인을 찾았다. 1번의 사례로는 Google의 Project Aristotle이 있다. Google은 “팀 효과성”이라는 재기 어려운 결과를 연구하면서 코드 줄 수나 버그 수정 수 같은 직접 지표를 버렸다. 버그를 많이 고쳤다는 건 처음에 버그를 많이 만들었다는 뜻일 수도 있어서다. 대신 임원·팀 리더·팀원의 평가와 영업 할당량 대비 실적을 대체 지표로 쓰고, 180개 팀을 대상으로 수백 건의 이중맹검 인터뷰와 250개 이상의 설문 문항을 분석했다(Google re:Work, 2015).
2단계: 관련성을 확인한다
원인 후보와 문제 사이에 관련이 있는지는 두 단계로 본다.
- 눈으로 확인한다. 산포도를 그려 두 지표가 함께 움직이는지 본다.
- 통계 지표로 확인한다. 상관계수를 계산한다.
상관계수는 -1에서 1 사이 값이고, 절댓값이 클수록 두 지표가 직선에 가깝게 함께 움직인다는 뜻이다. 책은 상관계수 값을 다섯 단계로 나눠 해석하는 기준을 소개하는데, 흔히 쓰는 기준은 아래와 비슷하다.
| 상관계수 절댓값 | 해석 |
|---|---|
| 0.0 ~ 0.2 | 거의 관련 없음 |
| 0.2 ~ 0.4 | 약한 관련 |
| 0.4 ~ 0.7 | 뚜렷한 관련 |
| 0.7 ~ 0.9 | 강한 관련 |
| 0.9 ~ 1.0 | 매우 강한 관련 |
단, 책도 강조하듯 이건 대략적인 기준이다. 데이터 수와 조건에 따라 상관계수의 정확도는 크게 달라진다. 점이 10개일 때 나온 0.6과 1,000개일 때 나온 0.6은 무게가 다르다. 표본이 작을 때 숫자가 얼마나 흔들리는지는 A/B 테스트에서 검정력 분석이 필요한 이유에서 다룬 이야기와 같다.
사례: Airbnb는 “효과 없음” 뒤에 숨은 원인을 쪼개서 찾았다
Airbnb는 검색 페이지 리디자인을 실험했는데 전체 결과는 사실상 효과 없음이었다. 여기서 “리디자인은 효과가 없다”로 끝내지 않고, 브라우저·국가·사용자 유형 같은 후보별로 결과를 나눠 봤다. 그러자 새 디자인이 구버전 인터넷 익스플로러(IE)에서 중요한 클릭 동작을 망가뜨리고 있었다. 버그를 고치자 IE에서도 다른 브라우저와 비슷하게 2% 넘는 개선이 나왔다(Airbnb Engineering, 2014-05-27).
결과가 나왔다고 끝난 게 아니라는 4장의 주장을 그대로 보여 주는 사례다. “효과 없음”이라는 결과도 원인을 찾아야 하는 출발점이었다.
원인을 찾을 때 빠지기 쉬운 함정 네 가지
1. 직접 관계인가, 간접 관계인가
책의 예시는 이렇다. 블로그 업데이트 빈도와 DAU 사이에 높은 상관관계가 나왔다. 그런데 마침 그 시기에 업데이트 빈도와 상관없이 유명 인플루언서가 블로그를 소개해 줬다. 이때 DAU를 올린 건 업데이트 빈도가 아니다.
책은 “데이터를 뒤져 보면 그 안에 반드시 답이 있을 것이다”라는 발상부터 리셋하라고 한다. 데이터를 보기 전에 그 관계가 말이 되는지, 다른 가능성은 없는지 먼저 생각해야 한다.
사례: Google Flu Trends는 독감이 아니라 겨울을 탐지했다. Google은 검색어로 독감 유행을 예측하는 Google Flu Trends를 만들었다. 5천만 개 검색어 중에서 과거 독감 데이터에 가장 잘 맞는 것을 고르는 방식이었다. 그런데 2013년 2월에는 미국 질병통제예방센터(CDC) 추정치의 두 배가 넘는 값을 예측했고, 2011년 8월부터 2013년 9월까지 108주 중 100주를 과대 추정했다. 개발진이 고등학교 농구처럼 독감과 무관한데 계절 때문에 함께 움직이는 검색어를 걸러 냈는데도, 계절성이 없던 2009년 H1N1 대유행은 놓쳤다. 논문은 이 모델을 “일부는 독감 탐지기, 일부는 겨울 탐지기”라고 평가했다(Lazer et al., Science, 2014-03-14). 검색어와 독감이 함께 움직인 이유의 상당 부분은 “겨울”이라는 제3의 변수였다.
2. 원인은 하나가 아닐 수 있다
실제 문제의 원인은 여러 개가 겹쳐 있거나 복잡한 경우가 많다. 앞의 토스뱅크 사례도 원인이 두 개였고, 첫 번째 원인(가치 전달)을 겨냥한 대책은 효과가 없었다. 원인을 하나 찾았다고 바로 멈추지 말고, 다른 후보도 남아 있는지 확인해야 한다.
사례: New Coke는 측정한 범위 밖의 원인을 놓쳤다. 코카콜라는 경쟁사 대비 점유율 우위가 15년 연속 조금씩 줄어들자, 20만 명에 가까운 소비자를 대상으로 맛 테스트를 하고 1985년 제조법을 바꿨다. 그러자 상담 전화가 하루 400통에서 1,500통으로 늘었고, 회사는 79일 만에 원래 제품을 다시 내놨다(The Coca-Cola Company). 회사 스스로 맛 테스트는 소비자가 브랜드에 느끼는 유대감을 보여 주지 못했다고 돌아본다. 맛은 원인 후보 중 하나였을 뿐인데, 측정한 것이 맛뿐이었다.
3. 직선이 아닌 관계도 있다
상관계수는 두 지표가 직선으로 함께 움직이는 정도를 잰다. 그래서 일정 수준까지는 오르다가 멈추는 관계, 구간마다 방향이 다른 관계는 상관계수가 낮게 나오거나 실제 모양을 숨긴다. 산포도를 먼저 그려야 하는 이유다.
사례: 소득과 행복. 카너먼과 디턴은 갤럽 응답 45만 건 이상을 분석해, 삶에 대한 평가는 소득과 함께 계속 오르지만 일상의 정서적 행복은 연 소득 약 7만 5천 달러 이후 더 오르지 않는다고 발표했다(Kahneman & Deaton, PNAS, 2010-09-07). 그런데 2023년 후속 연구에서는 이 정체 패턴이 가장 불행한 20% 집단에서만 나타났고, 가장 행복한 30% 집단은 10만 달러 이후 오히려 더 가파르게 올랐다(Killingsworth, Kahneman & Mellers, PNAS, 2023-03-01). 평균만 보면 하나의 곡선이지만, 집단별로는 모양이 다른 관계가 겹쳐 있었다.
책은 여기에 경고를 하나 붙인다. 어떻게든 결과를 숫자 하나로 나타내려고 매달리면 수단과 목적이 뒤바뀐다. 그러면 보고를 받는 사람은 내가 무엇을 했고 무엇을 하고 싶은지 이해하기 어려워진다. 관계가 직선이 아니면, 상관계수 하나보다 산포도 한 장이 더 정확한 전달일 수 있다.
4. 상관관계는 인과관계가 아니다
함께 움직인다고 해서 하나가 다른 하나를 일으킨 건 아니다. 4장의 마지막 주의 사항이고, 실무에서 가장 비싼 대가를 치르는 실수다. 상관관계와 인과관계의 차이를 보여 주는 사례 두 개를 골랐다.
사례: 호르몬 대체요법은 관찰연구와 실험의 결과가 반대였다. 간호사 5만 9천여 명을 최대 16년간 추적한 관찰연구에서는 에스트로겐과 프로게스틴을 함께 복용한 여성의 주요 관상동맥질환 상대위험이 0.39였다. 위험이 크게 줄어든 것처럼 보였다(Grodstein et al., NEJM, 1996). 그런데 같은 질문을 처음으로 무작위 실험으로 확인한 WHI 연구에서는 관상동맥질환 위험비가 1.29, 유방암 1.26, 뇌졸중 1.41로 오히려 위험이 늘었고, 시험은 조기 중단됐다(WHI Investigators, JAMA, 2002-07-17). 관찰된 상관관계를 효과로 믿었다면 반대 방향의 결론을 낸 셈이다.
사례: eBay의 검색광고는 효과가 거의 없었다. eBay는 브랜드 키워드(“ebay” 등) 검색광고를 끄는 실험을 했다. 광고로 들어오던 클릭의 99.5%가 자연 검색 결과로 그대로 들어왔다. 광고가 없어도 어차피 올 사람들이었다. 비브랜드 키워드는 미국 트래픽의 무작위 30%에서 60일간 광고를 껐다. 상관관계만 보는 단순 회귀로 계산한 광고 수익률은 4,173%였지만, 실험으로 추정한 수익률은 -63%였다(Blake, Nosko & Tadelis, Econometrica, 2015). 원래 살 생각이 있는 사람이 광고를 클릭한 것을, 광고 때문에 산 것으로 착각한 것이다.
월마트는 AI로 무엇을 바꾸고 있나에서도 같은 구조를 다뤘다. “Sparky를 쓰는 고객이 40% 더 쓴다”는 숫자도 원래 많이 사는 고객이 Sparky를 더 쓴 것일 수 있어서, 월마트 스스로 인과로 볼 수 없다고 밝혔다. 인과를 확인하는 가장 확실한 방법은 무작위 실험이고, 표본이 부족할 때 실험을 어떻게 설계하는지는 표본이 충분하지 않을 때 실험은 어떻게 해야 할까?에 정리했다.
내 블로그에 적용해 보기
2장 글에서 내 블로그의 문제를 “DAU가 적다”(하루 평균 약 5명)로 다시 정의하고, 원인 후보 세 개를 세웠다. 그리고 Search Console 숫자(2026-09-20 ~ 2026-10-12, 노출 72회, 평균 게재 순위 13.7)를 보고 “① 노출 부족은 숫자가 지지한다”고 판단했다.
4장의 기준으로 이 판단을 다시 보면 부족한 점이 보인다.
| 4장의 기준 | 2장 글에서 한 것 | 부족한 점 |
|---|---|---|
| 원인 후보 열거 | 노출 부족, 질 부족, 수 부족 | 충분하다. 다만 검색 밖 유입(직접 방문, SNS)은 후보에 없었다 |
| 지표 결정 | 노출 수, 게재 순위, CTR, 글 수 | 한 시점의 합계만 봤다. “움직임”을 비교할 시계열이 아니다 |
| 관련성 확인 | 하지 않았다 | 노출과 DAU가 함께 움직이는지 아직 보지 않았다 |
즉 2장 글의 “숫자가 지지한다”는 엄밀히 말하면 “노출이 적다”는 현재 상태 파악이지, “노출이 적어서 DAU가 적다”는 관련성 확인이 아니었다. 그래서 다음에 할 일을 이렇게 정했다.
- 지표를 시계열로 바꾼다. 일별 검색 노출 수와 일별 DAU를 같은 기간으로 나란히 뽑는다.
- 산포도부터 그린다. 상관계수는 그다음이다. 지금은 하루 DAU가 한 자릿수라 점이 몇십 개뿐이고, 상관계수 하나에 큰 의미를 두기 어렵다.
- 간접 관계를 의심한다. 예를 들어 AX 뜻 글은 2026-10-12에 제목과 구조를 개편했다. 이후 노출이 늘더라도 개편 덕분인지, 발행 후 시간이 지나 색인이 안정된 덕분인지 구분해야 한다. 책의 인플루언서 예시와 같은 구조다.
마치며: 결과가 나온 뒤에 던질 질문
분석 결과가 나왔다면 리포트를 닫기 전에 이 다섯 가지를 묻는다.
- 이 결과로 어떤 행동을 할 수 있는가? 행동으로 이어지지 않는다면 아직 원인까지 가지 않은 것이다.
- 원인 후보를 주관 없이 열거했는가? “당연히 이거지” 하고 걸러 낸 후보는 없는가.
- 후보마다 움직임을 비교할 지표가 있는가? 없다면 대체 지표, 지금부터 수집, 정성 정보 중 무엇으로 갈지 정했는가.
- 산포도를 먼저 봤는가? 상관계수만 보고 직선이 아닌 관계나 제3의 변수를 놓치지 않았는가.
- 상관관계를 인과관계로 말하고 있지 않은가? 인과라고 말하려면 실험이나 그에 준하는 근거가 있는가.
원인을 찾은 뒤 해결 방안을 고르는 순서, 그리고 “왜?”를 몇 번이나 물어야 하는지는 5장 정리에서 이어서 다룬다.
참고 자료
- 카시와기 요시키 (2021). 『빅데이터 시대, 성과를 이끌어 내는 데이터 문해력』 4장 원인 파악 능력. 강모희 옮김. 프리렉.
- 토스 (2024-03-22). 끊임없는 실험으로 고객에게 큰 가치를 제공하는, 토스뱅크 Data Analyst.
- Google re:Work (2015). Guide: Understand team effectiveness.
- Overgoor, J. (2014-05-27). Experiments at Airbnb. Airbnb Engineering.
- Lazer, D., Kennedy, R., King, G., & Vespignani, A. (2014). The Parable of Google Flu: Traps in Big Data Analysis. Science, 343(6176), 1203–1205.
- The Coca-Cola Company. New Coke: The Most Memorable Marketing Blunder Ever?
- Kahneman, D., & Deaton, A. (2010). High income improves evaluation of life but not emotional well-being. PNAS, 107(38), 16489–16493.
- Killingsworth, M. A., Kahneman, D., & Mellers, B. (2023). Income and emotional well-being: A conflict resolved. PNAS, 120(10), e2208661120.
- Grodstein, F., et al. (1996). Postmenopausal estrogen and progestin use and the risk of cardiovascular disease. NEJM, 335, 453–461.
- Writing Group for the WHI Investigators (2002). Risks and benefits of estrogen plus progestin in healthy postmenopausal women. JAMA, 288(3), 321–333.
- Blake, T., Nosko, C., & Tadelis, S. (2015). Consumer Heterogeneity and Paid Search Effectiveness: A Large-Scale Field Experiment. Econometrica, 83(1), 155–174.