데이터 팀은 LLM으로 무엇을 하고 있나
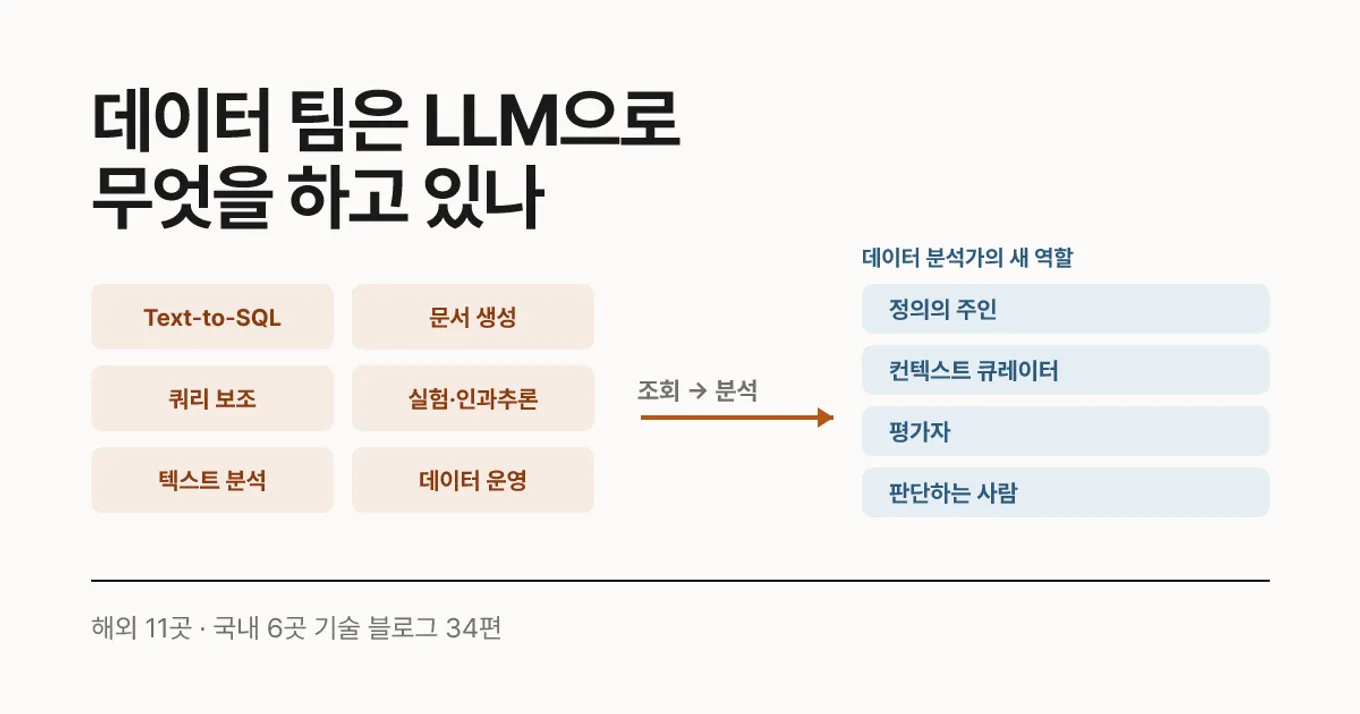
해외 빅테크와 국내 기업 기술 블로그 34편으로 정리한 데이터 분석 LLM 활용 사례입니다. LLM으로 하는 6가지 일, 성패를 가른 것, 다음 단계, 데이터 분석가의 역할 변화를 다뤘습니다.
목차
들어가며
결론부터: 데이터 팀의 LLM 활용은 “SQL을 대신 써 주는 봇”에서 “분석을 같이 하는 에이전트”로 넘어가는 중이다. 그리고 그 과정에서 성패를 가른 건 모델이 아니라 테이블과 지표의 정의였다. 데이터 분석가의 일도 쿼리를 쓰는 쪽에서 정의를 지키고, 평가하고, 판단하는 쪽으로 옮겨 가고 있다.
이 글은 2026년 10월에 해외 기업 11곳(Uber, LinkedIn, Pinterest, Airbnb, Netflix, Meta, Spotify, DoorDash, Instacart, Grab, Booking.com)과 국내 기업 6곳(우아한형제들, 당근, 토스플레이스, 카카오, LY, 오늘의집)의 기술 블로그와 클라우드 벤더 고객 사례까지 원문 34편을 읽고 정리한 것이다. 수치와 인용은 모두 원문에 있는 것만 옮겼고, 출처는 각 문단에 링크로 달았다.
데이터 팀이 LLM으로 하는 6가지 일
| 활용 | 대표 사례 | 원문 수치 |
|---|---|---|
| 1. Text-to-SQL·데이터 질의응답 | Meta, Pinterest, 토스플레이스, 당근페이 | Meta 데이터 직군 77%가 매주 사용, 토스플레이스 팀원 70% 사용 |
| 2. 메타데이터·문서 생성 | Pinterest, LinkedIn, 우아한형제들 | Pinterest 수작업 문서화 약 70% 감소 |
| 3. 쿼리 보조(에러 수정·해설) | LinkedIn, 우아한형제들 | LinkedIn “Fix with AI”가 전체 세션의 80% |
| 4. 실험·인과추론 | Netflix, Spotify, 당근 | Netflix 보조 구조가 있으면 10개 중 9개 정답 |
| 5. 비정형 텍스트 분석 | Airbnb, 오늘의집 | 오늘의집 VOC 리포트 월 20시간 → 1시간 |
| 6. 데이터 엔지니어링·운영 | Grab, Meta, 당근 | Grab 반복 업무에 쓰던 시간 약 40% |
1. Text-to-SQL과 데이터 질의응답. 거의 모든 회사가 하고 있다. Slack이나 사내 SQL 도구에서 자연어로 물으면 테이블을 찾고, SQL을 쓰고, 실행해서 답한다. Meta의 Analytics Agent는 데이터 사이언티스트·엔지니어의 77%가 매주 쓰고, Pinterest는 출시 2개월 만에 분석가의 40%가 쓰는 사내 1위 에이전트가 됐다. 국내에서는 토스플레이스의 판다를 팀원 70%가 쓰고 있고, 당근페이는 평균 1~3일 걸리던 분석 대기를 1분 이내 답변으로 바꿨다. Spotify의 데이터 어시스턴트 사용자 2,100여 명 중 4분의 1 이상은 SQL을 써 본 적이 없는 사람들이다.
2. 메타데이터와 문서 생성. LLM이 과거 쿼리와 기존 문서를 읽고 테이블·컬럼 설명을 쓴다. Pinterest는 AI가 만든 테이블 설명으로 수작업 문서화를 약 70% 줄였고, 75% 이상이 “쓸 만하다”고 평가했다. 다만 우아한형제들은 이 과정에서 “허위 생성 문제가 발생하여 일부 테이블에 대한 정보가 잘못 기입되는 경우”가 있었다고 썼다.
3. 쿼리 보조. 의외로 가장 많이 쓰이는 기능은 새 쿼리 생성이 아니었다. LinkedIn의 SQL Bot에서는 실패한 쿼리를 고쳐 주는 “Fix with AI”가 전체 세션의 80%를 차지했다. 분석가는 쿼리를 통째로 맡기기보다 자기가 쓴 쿼리를 고치는 데 AI를 더 많이 썼다.
4. 실험과 인과추론. Netflix는 관찰 데이터 인과추론을 사람(Principal), 실행 에이전트(Actor), 비평 에이전트(Critic) 세 역할로 나눴다. 공변량 균형, overlap, 위약 검정 같은 진단을 통과해야 결과를 인정한다. 이런 보조 구조가 있으면 무작위 데이터셋 10개 중 9개에서 정답을 맞혔고, 없으면 그럴듯하지만 편향된 답을 냈다. Spotify는 LLM 예측을 A/B 테스트의 대리 지표로 쓸 수 있는지 실험했는데, 보정 없이 쓰면 실제 효과의 39%만 잡혔다. “Raw LLM predictions are biased, not just noisy.” 그래서 LLM은 실험을 대신하기보다 약한 아이디어를 미리 거르거나 분산을 줄이는 보조 변수로 쓰자고 결론 내렸다. 분산을 줄이면 같은 표본으로 더 작은 차이를 잡을 수 있다는 점은 검정력 분석 글에서 다룬 내용과 이어진다.
5. 비정형 텍스트 분석. Airbnb는 고객지원 대화나 설문 주관식을 분류하고 세는 분석 방법론 자체를 도구로 만들어, 몇 달 걸리던 조사를 며칠로 줄였다. 1년 만에 수십 개 팀이 쓰고 있고, 기술 직군이 아닌 사용자가 더 많다. 오늘의집은 VOC 리포트 작성을 월 20시간에서 1시간 이내로 줄였다.
6. 데이터 엔지니어링과 운영. Grab의 데이터 웨어하우스 팀은 반복 문의와 장애 대응에 시간의 약 40%를 쓰다가, 에이전트를 붙여 해결 시간을 10분의 1 수준으로 줄였다. Meta는 데이터 접근 요청과 승인에, 당근은 리니지로 품질 이슈의 영향 범위를 찾는 데 쓴다.
성패를 가른 것: 테이블과 정의
34편을 읽으며 가장 많이 반복된 문장은 비슷했다. 어려운 건 SQL 작성이 아니라 “어떤 테이블의 어떤 정의를 쓸지”였다.
- Pinterest는 테이블 문서가 없을 때 테이블 검색 적중률이 40%였고, 문서 가중치를 높이자 최대 90%까지 올랐다.
- 당근페이는 샘플 쿼리 유무에 따라 정확도가 90% 이상 차이 났다고 썼다.
- Spotify는 “Just putting all schemas into an LLM doesn’t work at this scale”이라고 했다. 비슷한 테이블이 많으면 모델은 틀린 테이블을 자신 있게 고른다.
- Grab은 한 문장으로 정리했다. “Ambiguous definitions cause most analytics slop.”
그래서 잘된 곳은 모두 기반 정비를 먼저 했다. 토스플레이스는 표준 데이터 마트를 정하고 모든 테이블·컬럼에 설명을 채웠다. Pinterest는 테이블 40만 개를 10만 개로 정리하고 등급(Tier)을 매겼다. LY는 NL-to-SQL 전용 마트와 지표 온톨로지를 따로 만들었다. Booking.com은 지표 정의를 Semantic View 한 곳에 모으고, 정의를 바꿀 때는 두 사람의 승인을 받게 했다.
또 하나의 공통점은 이 지식을 도메인 팀이 소유한다는 점이다. Spotify는 도메인별 “cluster”(데이터셋, 검증된 질문-SQL 쌍, 용어 문서)를 담당 팀이 관리하고 건강 점수를 매긴다. Meta에서는 사람들이 분석 노하우를 “레시피”로 올리는데, 4,500개가 넘는 레시피가 15만 번 쓰였다. 결국 LLM에게 맞는 정보를 고르고 주는 일, 즉 컨텍스트 엔지니어링이 데이터 팀의 업무가 됐다.
그럴듯한 오답과 평가
가장 위험한 실패는 에러가 아니라 그럴듯한 오답이다. Meta는 이렇게 썼다. “a wrong number presented confidently is worse than no number at all.” LY는 구체적인 사례를 공개했다.
- 활동 유저 대신 로그인 유저를 집계함
- 테스트 계정 같은 제외 조건을 빠뜨림
- JOIN 중복으로 숫자가 부풀려짐
토스플레이스는 ‘활성 매장 수’가 설치 기준인지 결제 기준인지 구분하지 못하는 문제를 겪었고, 당근과 우아한형제들도 “문법적으로는 맞지만 비즈니스 로직을 반영하지 못하는” SQL을 한계로 꼽았다. SQL이 실행되고 숫자가 나오면 사람은 의심하지 않는다. 그래서 더 위험하다.
이걸 잡는 방법은 평가다. 잘하는 팀들의 평가 방식은 비슷했다.
| 방법 | 사례 |
|---|---|
| 실제 질문으로 평가셋 만들기 | DoorDash는 Slack·Jira에서 질문을 자동으로 모아 평가 문항 1,900개 이상을 쌓았다 |
| 정답 쿼리와 결과 비교 | Uber는 실제 로그에서 질문을 뽑아 정답 SQL을 사람이 검증했다 |
| LLM 채점 + 사람 확인 | LinkedIn은 LLM 채점이 75%의 경우 사람 점수와 1점 이내로 맞았다 |
| 실행 전 검증 | EXPLAIN 실행, 실제 테이블·컬럼 존재 확인, 결과가 0행인지 확인 |
DoorDash는 이렇게 평가하면서 통과율을 43%에서 90%로 올렸다. 같은 평가에서 범용 코딩 에이전트인 Claude Code는 48%, 사내 지식과 검증 단계를 붙인 자체 에이전트 Vera는 73%였다. 모델보다 그 주변 구조, 즉 에이전트 하네스가 차이를 만든 셈이다. 덧붙여 Uber는 평가 결과가 실행할 때마다 약 5% 흔들린다고 밝혔다. 평가 점수의 작은 차이를 개선으로 읽기 전에 잡음부터 확인해야 한다는 점은 실험 분석과 똑같다.
다음 단계 5가지
각 글의 “앞으로의 계획”을 모아 보면 방향이 다섯 갈래로 모인다.
1. 조회에서 분석으로. DoorDash는 다음 핵심 과제로 인과 분석과 실험 해석 같은 “harder, more subjective questions”를 꼽았다. Pinterest는 SQL 생성을 넘어 시각화 추천, Python 분석, 대시보드 생성까지 계획하고 있다. 국내에서도 우아한형제들은 “여러 기능을 결합한 AI 에이전트”, 토스플레이스는 “데이터 직군의 업무까지 실질적으로 덜어줄 수 있는 방향”, 오늘의집은 “다음 실험 아이디어를 제안하는 수준”을 목표로 적었다.
2. 에이전트가 읽을 지표 레이어. Pinterest는 이번 주(2026년 10월 6일) 에이전트를 위한 지표 레이어를 공개했다. Booking.com의 Semantic View, LY와 오늘의집이 준비하는 그래프 데이터베이스도 같은 방향이다. 지표 정의를 사람이 읽는 문서가 아니라 에이전트가 읽는 구조로 바꾸는 일이다.
3. 스키마 밖의 지식. Spotify는 다음 질문으로 이걸 던졌다. “What if the knowledge lies outside the schema?” 지표가 왜 그렇게 정의됐는지, 어떤 예외가 있는지 같은 지식은 테이블에 없고 사람의 머릿속과 문서에 있다.
4. 에이전트끼리의 연결. Pinterest는 다른 도메인 에이전트와의 협업을, Meta는 “사용자가 아니라 사용자를 대신하는 에이전트가 데이터에 접근하는” 상황을 다음 과제로 꼽았다. Uber는 사내 시스템을 에이전트에게 표준 방식으로 여는 MCP 게이트웨이를 만들었고, 당근은 2026년을 흩어진 시도를 통합하고 데이터 MCP의 거버넌스를 강화하는 해로 정했다.
5. 사람의 검증과 파이프라인 자동화. Uber는 재무 에이전트 Finch에 리더가 요청하면 사람이 검증하는 단계를 넣을 계획이다. 반대쪽 끝에서는 Booking.com이 데이터 파이프라인을 AI가 직접 만드는 것을 “next frontier”로, Grab은 스스로 복구하는 파이프라인을 이미 운영 중이다.
데이터 분석가의 역할은 어떻게 바뀌나
쿼리를 쓰는 일은 빠르게 AI 몫이 되고 있다. 토스플레이스는 데이터 팀 요청의 70%가 단순 추출이었다고 했고, Grab에서는 SQL 요청 중 사람 개입 없이 처리되는 비율이 50%에서 81%로 올랐다. 그럼 분석가는 무엇을 하게 될까. 조사한 글들에 나타난 변화를 네 가지 역할로 정리해 봤다. 역할 구분은 내 해석이고, 근거는 각 회사의 사례다.
| 역할 | 하는 일 | 근거 사례 |
|---|---|---|
| 정의의 주인 | 지표·용어 정의를 정하고 한 곳에서 관리한다 | Booking.com 정의 변경 2인 승인, 토스플레이스 표준 마트 |
| 컨텍스트 큐레이터 | 검증된 쿼리, 레시피, 도메인 문서를 쌓고 낡은 것을 걷어낸다 | Spotify cluster 소유, Meta 레시피 4,500개, LinkedIn “champions” |
| 평가자 | 정답 쿼리와 평가셋을 만들고 AI의 답을 채점한다 | DoorDash 평가 문항 1,900개 이상 |
| 판단하는 사람 | 문제를 정의하고, 인과를 식별하고, 어떤 결과를 믿을지 정한다 | Netflix의 Principal, Instacart |
1. 정의의 주인. “활성 사용자”가 무엇인지 정하는 일은 AI가 대신할 수 없다. 정의가 모호하면 AI는 그 모호함을 빠르고 크게 퍼뜨린다. 분석가가 지표 정의를 시맨틱 레이어나 표준 마트에 박아 두는 일이, 대시보드를 하나 더 만드는 일보다 훨씬 큰 영향을 갖게 됐다.
2. 컨텍스트 큐레이터. LinkedIn은 정확도를 높이는 다음 방법으로 각 영역의 “champions”가 직접 컨텍스트를 관리하게 하는 것을 꼽았다. Spotify는 과거 쿼리로 자동 생성한 질문-SQL 쌍 중 전문가가 받아들인 건 12.5%뿐이었다고 밝혔다. 자동으로 모은 지식을 그대로 쓸 수 없고, 도메인을 아는 사람이 골라야 한다는 뜻이다.
3. 평가자. AI의 답이 맞는지 판정하는 기준은 결국 분석가가 만든다. 정답 쿼리를 쓰고, 그럴듯한 오답의 유형을 모으고, 평가셋을 실제 질문으로 계속 갱신하는 일이다. 실험에서 가드레일 지표를 정해 두고 지키는 것처럼, AI 분석에도 “이 선을 넘으면 믿지 않는다”는 기준이 필요하다.
4. 판단하는 사람. Netflix의 인과추론 워크플로에서 사람(Principal)은 분석 계획, 교란 변수, 쓸 데이터를 정하고, 에이전트는 그걸 실행하고 점검한다. Instacart의 경제학 팀은 AI 도입 후 팀 업무가 어떻게 바뀌었는지 측정했는데, 다음 변화로 “problem framing, modelling, causal identification, deciding which results to trust” 같은 판단 중심 업무로의 이동을 예상했다. Instacart는 이미 2024년에 데이터 사이언스 SQL 면접을 AI를 쓰는 방식에 맞춰 바꾸겠다고 밝혔다.
그래서 지금 분석가가 준비할 것을 꼽으면 이렇다.
- 지표 정의서와 표준 마트를 먼저 정비한다. AI 도입 전에 하든 후에 하든, 결국 여기서 성패가 갈린다.
- 자주 받는 질문 20개와 그 정답 쿼리를 모아 둔다. 이게 그대로 평가셋이자 AI에게 줄 예시가 된다.
- AI가 쓴 SQL을 검토하는 눈을 기른다. JOIN 중복, 제외 조건 누락, 지표 정의 혼동처럼 그럴듯한 오답의 패턴을 알아야 잡을 수 있다.
- 실험 설계와 인과추론 같은 판단 영역을 깊게 판다. 조회가 자동화될수록 “이 숫자를 믿어도 되는가”를 답하는 능력의 가치가 올라간다.
마치며
- 데이터 팀은 LLM을 Text-to-SQL, 문서 생성, 쿼리 보조, 실험·인과추론, 텍스트 분석, 데이터 운영 여섯 가지에 쓰고 있다. 가장 많이 쓰이는 건 새 쿼리 생성보다 기존 쿼리를 고치고 설명하는 보조 기능이었다.
- 성패를 가른 건 모델이 아니라 테이블과 지표의 정의, 그리고 그 지식을 도메인 팀이 관리하는 구조였다.
- 가장 위험한 실패는 그럴듯한 오답이고, 실제 질문으로 만든 평가셋이 그걸 잡는다.
- 다음 단계는 조회에서 분석으로, 에이전트가 읽을 지표 레이어, 스키마 밖 지식, 에이전트끼리의 연결, 사람 검증이다.
- 데이터 분석가는 쿼리를 쓰는 사람에서 정의를 지키고, 컨텍스트를 고르고, 답을 평가하고, 판단하는 사람으로 옮겨 가고 있다.
이 글에 쓴 34편의 원문 목록은 각 문단의 링크로 확인할 수 있다. 국내 사례는 정확도 실측치를 공개한 글이 거의 없었다는 점도 덧붙여 둔다.