핀터레스트 Metrics Board로 보는 지표 레이어
핀터레스트가 공개한 에이전트용 지표 레이어 Metrics Board를 정리했습니다. 지표를 한 번 정의하면 계산, 품질 검증, 배포, 에이전트 검색까지 이어지는 구조와 성과를 다뤘습니다.
목차
들어가며
결론부터: 사람이 믿을 수 있게 만든 지표가 곧 에이전트가 쓸 수 있는 지표다. 핀터레스트 엔지니어링 팀은 2026년 10월 6일 공개한 글 Metrics Board: Building an Agent-ready Metrics Layer를 이렇게 정리했다.
As it turns out, the work we did to make metrics trustworthy for humans is what makes them usable by agents.
데이터 팀은 LLM으로 무엇을 하고 있나에서 34편의 기술 블로그를 읽고 정리한 다음 단계 중 하나가 “에이전트가 읽을 지표 레이어”였다. Metrics Board는 그 방향을 가장 구체적으로 보여주는 사례다. 이 글에서는 원문과 본문 이미지(YAML 예시, 편집 화면, 파이프라인 그래프, 카탈로그 화면)를 바탕으로 구조와 설계 선택, 성과를 정리하고, 작은 팀이 가져올 만한 점을 덧붙였다.
왜 지표 레이어가 필요했나
핀터레스트에서는 분석가, 데이터 사이언티스트, 엔지니어 수백 명이 페타바이트 규모 데이터 레이크에서 수천 개의 지표를 만든다. 그리고 어느 시점에든 실험이 수천 개 돌아가는데, 이 실험들이 새 기능 출시의 관문 역할을 한다. 원문은 이렇게 쓴다. “For results to be fair, comparable, and statistically significant, metrics must be clearly defined, reliable, and reusable.”
실험에는 공통 핵심 지표만으로 부족하다. 새로운 상호작용을 추가하는 기능이라면, 핵심 참여 지표가 그대로여도 그 새 행동을 재는 지표가 있어야 성공 여부를 판단할 수 있다. 그래서 기능마다 맞춤 지표가 계속 생긴다.
Metrics Board 이전에는 이 지표들을 각자 만든 파이프라인으로 계산하고, 리포팅과 실험 도구에 손으로 연결했다. 원문이 꼽은 문제는 네 가지다.
- 비슷한 파이프라인을 손으로 반복해서 만드느라 느렸다.
- 모니터링이 들쭉날쭉해서 고장이 하류에서야 드러났다.
- 이미 있는 지표를 몰라 중복이 생기고 신뢰가 떨어졌다(“Low awareness of existing metrics, leading to redundancy and trust erosion”).
- 지표 메타데이터가 곳곳에서 어긋났고 기준이 되는 원본이 없었다(“no source of truth”).
여기에 새 요구가 더해졌다. 질문이 SQL이나 대시보드 필터가 아니라 에이전트에게 자연어로 들어오기 시작한 것이다. “But agents are only as good as the trusted data they can access.” 에이전트 분석이 제대로 되려면 지표가 찾기 쉽고, 품질이 검증되고, 기계가 읽을 수 있어야 했다.
정의는 한 번, 나머지는 자동으로
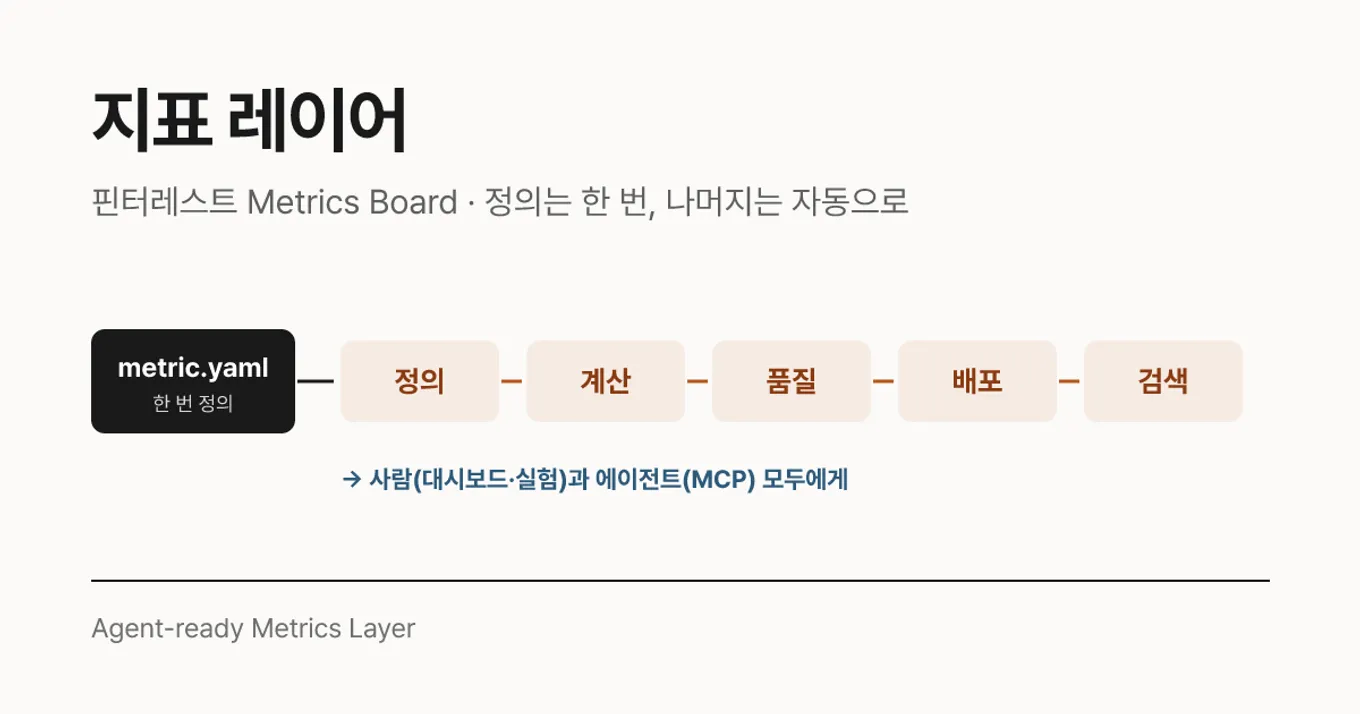
Metrics Board의 한 줄 요약은 이렇다. “Define a metric once, Metrics Board handles the rest.” 지표를 한 번 정의하면, 그 정의 하나가 계산부터 배포까지 하류의 모든 것을 움직인다. 원문은 이를 다섯 개의 축으로 설명한다.
| 단계 | 하는 일 | 이전 | 지금 |
|---|---|---|---|
| 1. 정의 (Inventory) | 지표 메타데이터 관리 | 흩어져 있고 관리되지 않음 | 한 곳에서 관리 |
| 2. 계산 (Compute) | 지표마다 파이프라인 | 수작업 | 지표별 독립 파이프라인 자동 생성 |
| 3. 품질 (Quality) | 검증과 알림 | 품질 검사 없음 | 자동 검증 |
| 4. 배포 (Publish) | 실험·BI·카탈로그로 내보내기 | 도구마다 손으로 연결 | 자동 배포 |
| 5. 검색 (Discovery) | 찾고 쓰기 | 사람만 | 사람과 에이전트 모두 |
1. 정의: 지표를 코드처럼 다룬다. 모든 지표는 전용 Git 저장소에 YAML 파일 하나로 산다. 버전 관리, 코드 리뷰, 변경 이력이 그대로 따라온다. 원문에 실린 YAML 예시와 편집 화면 예시를 합쳐 간추리면 이런 모양이다.
metric_id: signupsdisplay_name: Signupsdescription: 스팸이 아닌 가입 수, 성별·국가별 집계domain: core_engagementmetric_sql: | SELECT dt, gender, country, sum(count_sa) AS signups FROM data.user_event_metrics_sa WHERE dt = '{end_date}' AND event_type = 40 GROUP BY 1, 2, 3temporal_columns: - column_name: dt granularity: DAYintegrations: superset: { enabled: true } starrocks: { enabled: true }compute: schedule: "0 9 * * *"다만 사용자가 YAML을 직접 쓰지는 않는다. 화면의 입력 폼을 채우면 시스템이 YAML을 만들고 대신 PR을 연다. 리뷰를 거쳐 병합되면 정의가 확정된다.
2. 계산: 지표 하나에 파이프라인 하나. 정의마다 Airflow DAG가 따로 만들어진다. 원문은 그 이유를 이렇게 쓴다. “Isolating each metric in its own DAG lets us tune schedules, retries, and resources individually, and prevents a failure in one cascading to others.” SQL은 정의에 적힌 엔진에 맞춰 SparkSQL이나 PrestoSQL로 바뀌고, SQL 파서(sqlglot)로 SQL을 분석해 상위 데이터가 준비될 때까지 기다리는 작업도 자동으로 붙는다. 상위 데이터가 늦게 오면 도착을 감지해 계산을 이어 가고, 과거 데이터 재계산(백필)도 Airflow로 한다. 덕분에 “What used to take days or weeks to build can now be achieved in 1–2 hours.”
4. 배포: 플래그 하나로 여러 도구에. 정의 안의 연동 플래그를 켜면 지표가 데이터 카탈로그(PinCat, DataHub 기반), 실험 플랫폼(Helium), BI(Superset), 분석용 웨어하우스(StarRocks)로 퍼진다. 배포는 두 단계로 나뉜다. 카탈로그와 실험 플랫폼처럼 메타데이터만 필요한 곳에는 정의가 병합되는 순간 배포하고, BI와 웨어하우스처럼 데이터가 필요한 곳에는 계산이 끝날 때마다 배포한다. 그래서 이런 일이 가능하다. “The metric is catalogued and available to experiments before it has even run.” 지표가 한 번도 계산되기 전에 이미 카탈로그에서 찾을 수 있고, 실험에 붙일 수 있다.
신뢰를 눈에 보이게: 품질 검증과 등급
3번 품질 단계는 따로 볼 만하다. 원문의 원칙은 짧다. “A metric nobody trusts is worse than no metric.”
검증은 지표 자체의 파이프라인 안에서 돈다. 계산이 끝나면 비어 있지 않은지, 중복이 없는지 같은 기본 검사가 자동으로 붙고, 그 위에 두 종류의 검사를 더한다.
- 규칙 기반 검사: 전일·전주·전월·전년 대비 변화 임계값, 직접 정한 규칙, 상위 지표와의 비교
- 머신러닝 이상 탐지: 지표의 계절성, 추세, 평소의 변동폭을 학습해 고정 규칙이 놓치는 이탈을 잡는다
알림은 검증 직후 지표를 소유한 팀으로 가고, 잠시 끄거나 확인 처리할 수 있다. 알림이 소음이 되지 않게 하려는 장치다. 중요한 건 검증 규칙이 지표 정의와 같은 YAML 파일 안에 산다는 점이다. 그래서 품질 기준도 정의와 함께 버전 관리되고 리뷰된다.
그리고 신뢰를 등급으로 보여준다.
- 지표 등급: Unknown → C → B → A → A+. 올라갈수록 더 많은 품질 작업이 필요하고, A+는 데이터 품질 담당자(Data Quality Steward)가 직접 확인한 지표다. “It tells consumers what to trust and shows owners exactly how to level up.” 쓰는 사람에게는 무엇을 믿을지, 만든 사람에게는 무엇을 더 해야 하는지를 알려준다.
- 대시보드 티어: 1~3단계. Tier 1은 회사 핵심 대시보드로 문서화와 인증이 가장 엄격하고 쿼리 성능 우선권을 받는다. Tier 3은 탐색용 기본값이고 쓰이지 않으면 자동으로 정리된다. 티어에 따라 보관 기간과 쿼리가 도는 클러스터가 자동으로 정해진다.
쓰이지 않는 지표를 정리하는 수명주기 정책도 함께 만들었다. 지표는 만드는 것만큼 버리는 것도 중요하다.
에이전트-레디란 무엇인가
여기까지는 사람을 위한 지표 관리처럼 보인다. 그런데 이게 그대로 에이전트를 위한 기반이 된다.
에이전트가 지표를 찾는 방법. 모든 지표가 자동으로 카탈로그에 등록되고, 핀터레스트는 그 위에 MCP 서버를 열었다. “We expose an MCP server so any LLM-based tools can find metrics, read their definitions, and reason about them.” 에이전트는 지표를 검색하고, 정의(SQL, 시간 컬럼, 차원)와 소유자, 등급, 품질 신호를 읽고, 그걸 바탕으로 답한다.
실제 사례. 핀터레스트의 Analytics Agent는 지표에 대한 자연어 질문에 답할 때 검증된 정답 쿼리(golden query)와 인증된 지표 정의를 참조한다. 원문은 이렇게 쓴다. “the agent ensures its responses are grounded in trusted, governed data.” 이 에이전트는 출시 2개월 만에 분석가의 40%가 쓰는 사내 1위 에이전트가 됐다(이전 글).
이게 왜 중요한지는 데이터 팀 LLM 활용 사례들을 떠올리면 분명해진다. 데이터 에이전트의 가장 위험한 실패는 그럴듯한 오답이고, 그 원인의 대부분은 모호한 지표 정의였다. 에이전트가 “활성 사용자”를 직접 SQL로 다시 정의하는 대신 등급 A인 공식 지표를 가져다 쓰면, 오답의 여지가 크게 줄어든다. 컨텍스트 엔지니어링의 표현으로 하면, 에이전트에게 맞는 컨텍스트를 고르는 일을 지표 레이어가 미리 해 둔 셈이다.
“얇은” 시맨틱 레이어라는 선택. 지표를 정의하는 방식에서 핀터레스트는 중요한 갈림길을 만났다. 테이블 위에 엄격한 데이터 모델을 강제하고 지표를 그 모델의 표현식으로 정의할 것인가, 아니면 어떤 SQL이든 받고 시간 컬럼과 차원 같은 정보만 사용자가 붙이게 할 것인가. 핀터레스트는 후자를 택했다.
enforcing a semantic layer for each was simply not realistic.
사용자 피드백, 그리고 지표에 쓰이는 테이블이 너무 다양하다는 현실 때문이다. 그래서 스스로를 “a thin semantic layer”라고 부른다. 완벽한 모델링보다 모두가 실제로 쓰게 만드는 것을 우선한 선택이다.
성과
원문에 공개된 수치는 이렇다.
| 항목 | 수치 |
|---|---|
| 지표 하나를 만드는 시간 | 며칠 |
| 매달 새로 만들어지는 지표 | 약 150개 |
| 실험용 지표 중 Metrics Board를 거치는 비율 | 98% 이상 |
| 핵심 참여 지표 개편 프로젝트 | 기존 방식 대비 약 2 엔지니어링-월 절감 |
| 전체 | “thousands of hours saved each month” |
다만 읽을 때 감안할 점이 있다. 절감 시간을 어떻게 계산했는지는 원문에 없고, 지표 추가 기간은 한 곳에서는 “1~2시간”, 다른 곳에서는 “몇 주에서 며칠”로 다르게 나온다. 각 등급(C, B, A)의 구체적인 요건이나 MCP 서버의 도구 목록, 에이전트 답변의 정확도도 공개되지 않았다. 한계나 향후 계획을 따로 다룬 섹션도 없다. 원문의 마지막 방향은 한 문장이다. 지금까지 쌓은 거버넌스, 품질, 카탈로그가 “quickly becoming the foundation for the LLM and agentic use cases we’re now shipping.”
마치며: 작은 팀이 가져올 것
Metrics Board는 수백 명의 데이터 생산자가 있는 회사의 플랫폼이지만, 원리는 작은 팀에도 그대로 쓸 수 있다. 아래는 원문을 바탕으로 한 내 정리다.
- 지표 정의를 코드로 남긴다. 위키 문서가 아니라 버전 관리되는 파일 하나에 정의, SQL, 소유자, 검증 규칙을 함께 둔다. dbt를 쓴다면 metrics나 semantic model 정의가 그 자리다. 이 블로그도 GA4 이벤트를 코드의 이벤트 정의와 문서로 함께 관리하고, 빌드 때 둘이 어긋나면 실패하도록 해 두었다. 규모는 작아도 같은 발상이다.
- 검증 규칙을 정의 옆에 둔다. 비어 있지 않은지, 중복이 없는지, 전주 대비 급변하지 않았는지. 이 정도만 자동으로 돌아도 “하류에서야 고장을 발견하는” 일이 크게 준다.
- 신뢰를 눈에 보이게 표시한다. 등급이든 “공식/실험용” 태그든, 이 지표를 믿어도 되는지 한눈에 보이게 한다. 사람에게도 에이전트에게도 같은 신호가 된다.
- 실험과 지표를 같은 정의로 묶는다. 실험 결과를 비교 가능하게 만드는 건 지표 정의의 일관성이다. A/B 테스트 가드레일 지표처럼 실험마다 반복해서 쓰는 지표일수록 먼저 정의 레이어에 올려 둘 가치가 크다.
- 에이전트 도입 전에 지표 레이어부터. 데이터 에이전트를 만들고 싶다면 모델이나 프롬프트보다 “에이전트가 가져다 쓸 공식 지표 목록”을 먼저 만드는 편이 빠르다. 핀터레스트가 보여준 순서가 그렇다. 사람을 위한 신뢰 작업이 먼저였고, 에이전트는 그 위에 올라탔다.