데이터 문해력: 결과는 결론이 아니다
『데이터 문해력』 6장 정보 집약력을 정리했습니다. 데이터 분석 결론 도출에서 결과와 결론의 차이, 그래프로 결론을 보여 주는 법, 결론을 낼 때 주의할 세 가지를 Challenger·Bing 사례와 내 블로그 숫자로 다룹니다.
목차
들어가며
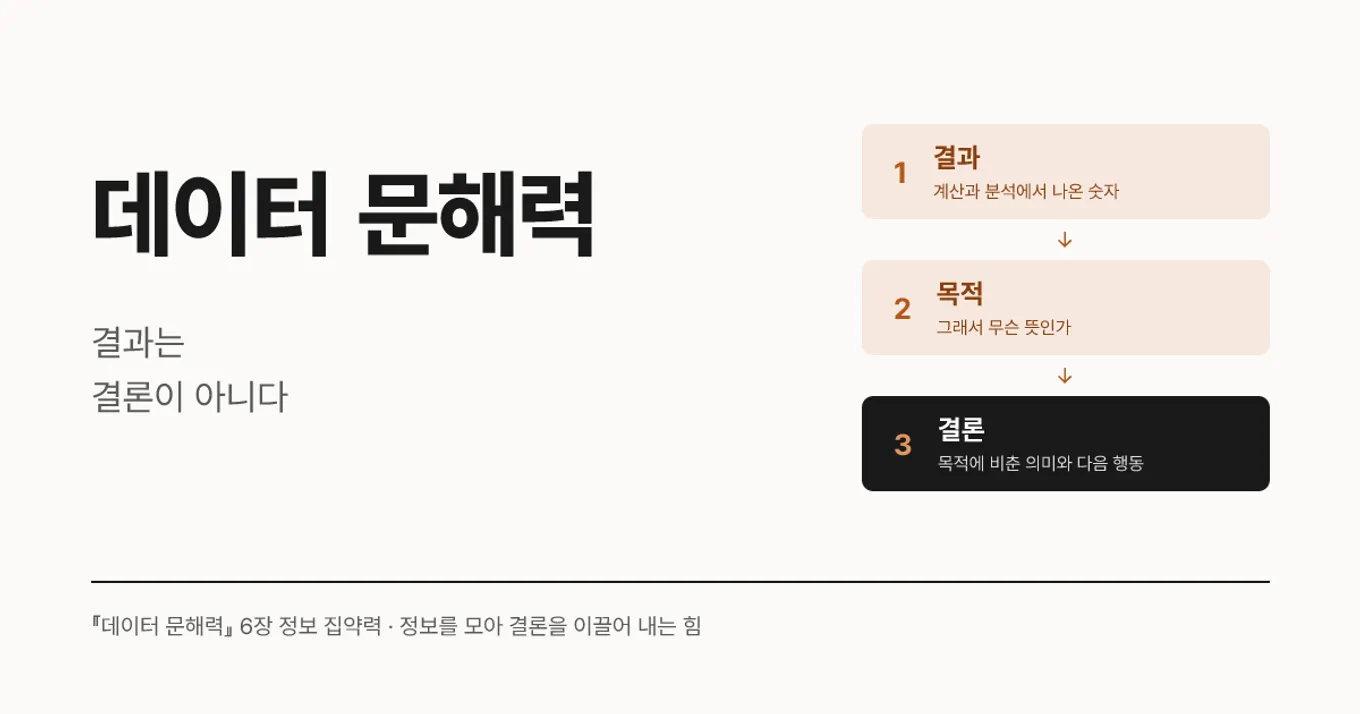
결론부터 말하면, 데이터 분석 결론 도출은 숫자를 구하는 일이 아니라 그 숫자가 목적에 대해 무슨 뜻인지 말하는 일이다. 『데이터 문해력』 6장 “‘결론은 이것이다’ 정보를 요약하라”는 이 힘을 정보 집약력이라고 부른다. 정보를 수집하고 결론을 이끌어 내는 힘이다.
4장 정리에서는 원인을 찾는 순서를, 5장 정리에서는 문제, 원인, 해결 방안을 잇는 법을 다뤘다. 6장은 그 끝에서 분석한 내용을 한 문장으로 모으는 단계다.
이 글은 6장을 세 부분으로 나눠 정리한다.
- 결과와 결론은 무엇이 다른가
- 그래프로 결론을 보여 주려면 어떻게 하는가
- 결론을 낼 때 무엇을 조심해야 하는가
각 부분에 실제 사례를 붙였다. 조사하다 보니 유명한 일화 중에는 원문과 다른 것이 꽤 있었다. 그런 경우는 원문 기준으로 고쳐 적었다. 마지막에는 내 블로그의 Search Console 숫자로 같은 일을 해 봤는데, 5장 글에 내가 쓴 문장 하나를 고쳐야 했다.
결과와 결론은 다르다
결과는 숫자, 결론은 목적에 대한 답
책의 구분은 이렇다.
계산과 분석을 해서 나온 결과물은 어디까지나 ‘결과’이며, 그 결과가 목적에 대해 어떤 의미가 있는지 설명하는 것이 ‘결론’입니다.
둘은 이어져 있다. 결론은 결과를 기반으로 도출하기 때문에 과정은 본질적으로 같다. 다른 것은 표현 방식이다. 책은 이 작은 차이가 상대방에게 전달되는 방식과 이해도에 큰 영향을 미친다고 본다.
전직 McKinsey 컨설턴트 Ameet Ranadive의 글에 이 차이를 보여 주는 예가 있다(Medium, 2013-08-17).
| 문장 | |
|---|---|
| 결과 | 계약 단계까지 간 거래의 50%가 성사됐다 |
| 결론 | 역대 평균 성사율 60%보다 낮아서 우려스럽다. 이 문제를 빨리 다뤄야 한다 |
쓰인 숫자는 같다. 그런데 결과 문장을 받은 사람은 “그래서 어쩌라고?”를 다시 물어야 한다. Ranadive는 파트너들이 자주 “‘그래서 뭐?(So what?)’는 어디 있나”라고 물었다고 적었다. 그가 든 공식은 “종합 = 요약 + 통찰”이다.
왜 결론까지 못 가는가
책은 배경 중 하나로 “실천적인 훈련이 부족한 정답 외주 교육”을 든다. 내가 읽은 대로 풀면, 정답이 정해진 문제를 푸는 데 익숙해서 답을 스스로 정하는 연습이 적었다는 뜻이다. 계산에는 정답이 있지만 결론에는 없다. 결론을 내려면 “나는 이렇게 판단한다”고 말해야 하고, 틀릴 위험도 함께 져야 한다. 그래서 리포트가 표와 그래프에서 멈추기 쉽다.
Barbara Minto는 McKinsey에서 보고서를 고치던 시절의 문제를 언어가 아니라 사고에서 찾았다. “문제는 언어가 아니라 사고였다.” Alumni 기사는 당시 보고서를 “결과(findings)와 결론(conclusions)이 뒤섞여 어느 쪽도 권고로 분명하게 이어지지 않는” 상태로 요약했다(McKinsey Alumni News). 6장이 말하는 문제와 같다.
사례: 데이터팀은 결론을 양식으로 강제한다
결론을 개인의 습관에 맡기지 않는 조직도 있다.
- Airbnb는 분석 지식을 모으는 Knowledge Repo 템플릿에
tldr항목을 넣었다. 글이 답하는 질문 바로 뒤에 핵심 결론을 쓰라는 뜻이다. 템플릿의 예시는 “임박 예약자에게 쓸 만한 공급이 남아 있는가?”라는 질문에 “임박 검색의 20%만 공급이 충분하다. 임박 검색이 아닌 경우는 60%다”라고 답한다. 학술 논문식 초록은 피하라는 안내도 있다(GitHub, 2016). Airbnb의 신입 데이터 과학자 조언 글도 상대가 궁금한 것은 “부록이 아니라 TL;DR”이라고 적었다(Airbnb Tech Blog, 2019-03-12). - Shopify 데이터팀은 “그래프 한 장이나 통계 하나만 던지지 않으려 한다. 대신 발견한 내용을 우리의 의견, 권고와 함께 적는다”고 밝혔다(Shopify Engineering, 2020-06-18).
두 회사의 공통점은 “의견”을 데이터팀의 일로 본다는 것이다. 결론을 내는 일을 읽는 사람에게 떠넘기지 않는다.
사례: Challenger, 결과는 그대로인데 결론이 뒤집혔다
결과와 결론의 거리가 가장 비싸게 드러난 사례는 1986년 우주왕복선 Challenger 사고다. 아래는 Rogers 위원회 보고서를 기준으로 정리했다(5장, 6장, 1986-06-06).
발사 전날 밤, 부스터 제조사 Thiokol의 엔지니어들은 이전 비행의 O-링 손상 기록과 시험 결과를 담은 차트를 NASA에 보여 줬다. 처음 결론은 분명했다. 권고 차트에는 “발사 시 O-링 온도는 53°F 이상이어야 한다”고 적혀 있었다.
그 뒤 Thiokol 경영진이 약 30분간 따로 논의했다. 이 자리에서 한 임원은 엔지니어링 담당 부사장에게 “엔지니어 모자를 벗고 경영자 모자를 쓰라”고 요구했다. 밤 11시 45분(동부 시간) 무렵 NASA에 팩스로 간 문서의 문장은 이렇게 바뀌어 있었다. “온도 데이터는 1차 O-링 블로바이를 예측하는 데 결정적이지 않다.” “STS-51L 발사를 진행할 것을 권고한다.”
같은 결과에서 정반대 결론이 나왔다. 그리고 발사 결정권자인 Jesse Moore와 Arnold Aldrich에게는 처음의 53°F 권고가 전달되지 않았다. 보고서는 이 문제들이 비행 준비 과정에서 분명하게 제기됐다면 “발사가 이뤄지지 않았을 가능성이 높아 보인다”고 적었다.
한 가지 더 있다. 보고서 6장에 따르면 O-링 온도가 66°F 이상이던 비행 20회 중 열 손상은 3회였지만, 63°F 이하이던 비행 4회는 전부 손상이 있었다. 보고서는 “NASA도 Thiokol도 이런 분석을 하지 않았다”고 적었다. 온도와 손상을 나란히 놓은 유명한 산점도도 사고 뒤에 그린 것이다. 발사 전 회의 자료에는 없었다. 결과가 흩어져 있으면 결론은 약해진다.
사례: Columbia, 슬라이드 제목이 결론을 가렸다
2003년 Columbia 사고에서는 결론의 표현이 문제가 됐다. 사고조사위원회(CAIB) 보고서는 발사 때 떨어진 단열재의 영향을 분석한 엔지니어의 슬라이드를 따로 다뤘다(CAIB Report Vol. I, 2003-08, 191쪽).
슬라이드 제목은 “시험 데이터를 검토한 결과 보수적임을 확인(Review of Test Data Indicates Conservatism)“이었다. 읽는 사람은 손상 예측이 보수적이니 안심해도 된다고 받아들이기 쉽다. 그러나 보고서에 따르면 이 말은 예측된 손상이 아니라 예측에 쓴 시험 모델의 선택을 가리켰다. 핵심 정보는 슬라이드 맨 아래에 있었다. 한 추정치로는 단열재가 모델 보정에 쓴 데이터보다 640배 컸다. (나중 분석에서는 400배로 나왔다.)
보고서의 평가는 이렇다.
고위 관리자가 이 슬라이드를 읽고도 생명을 위협하는 상황을 다룬다는 사실을 알아차리지 못했을 수 있다는 점은 쉽게 이해할 수 있다.
결과는 슬라이드 안에 있었다. 그런데 결론이 제일 위가 아니라 제일 아래에 있었고, 제목은 다른 것을 말했다.
그래프로 결론을 보여 준다
요약 숫자만 보면 데이터를 너무 단순하게 이해한다
6장 두 번째 절은 데이터를 너무 단순하게 이해한 사례를 다룬다. 평균이나 합계 같은 결과 하나로 결론을 내면 놓치는 것이 많다. 이 문제를 가장 잘 보여 주는 자료가 Anscombe의 1973년 논문이다(Anscombe, The American Statistician, 1973). 그가 만든 가상의 데이터 네 개는 평균도 회귀식도 R²도 같다. 그런데 그려 보면 전혀 다르다.
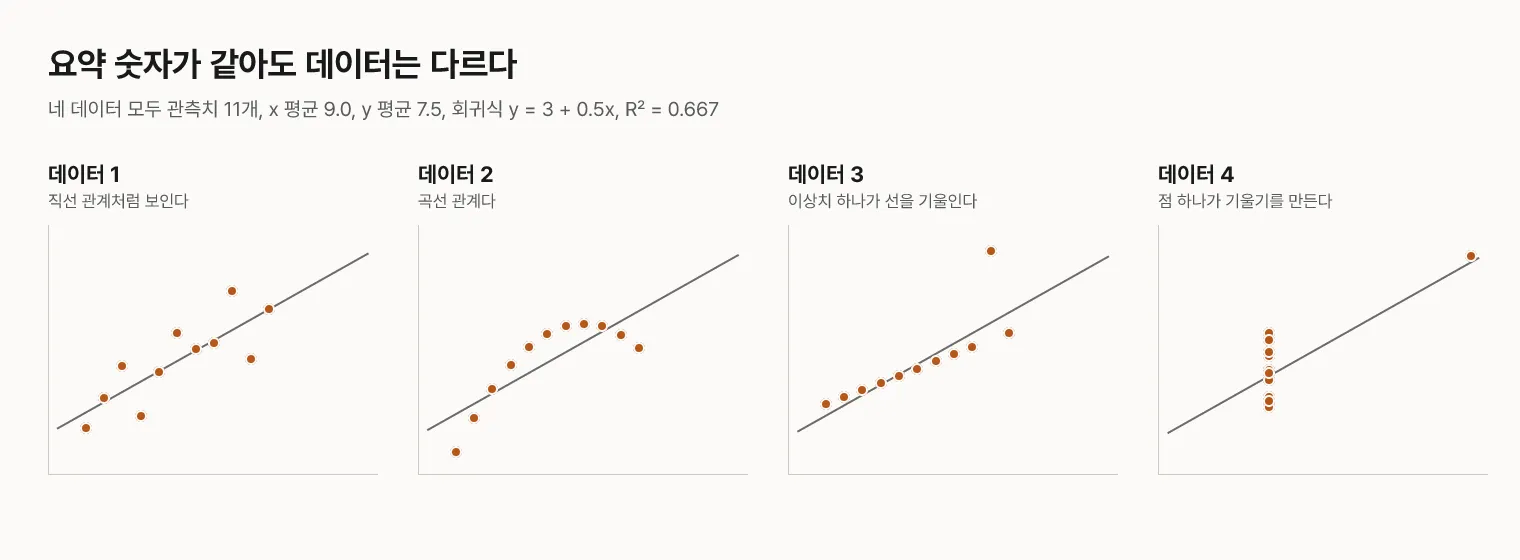
표로 받은 결과가 “R² 0.667”이라면 네 경우 모두 결론이 같아진다. 그래프를 보면 2번은 직선 모형이 틀렸고, 4번은 점 하나를 빼면 분석이 성립하지 않는다는 것을 알 수 있다. Anscombe는 이렇게 썼다. “컴퓨터는 계산과 그래프를 모두 만들어야 한다. 둘 다 살펴봐야 한다.”
단순한 이해의 비용을 보여 주는 또 다른 사례는 UC Berkeley 대학원 입학 데이터다(Bickel et al., Science, 1975-02-07). 1973년 가을 지원서 12,763건을 전체로 집계하면 남성 약 44%, 여성 약 35%가 합격했다. 여기서 멈추면 결론은 “여성 차별”이다.
101개 학과로 나눠 보니 달랐다. 여성에게 불리한 학과는 4곳, 남성에게 불리한 학과는 6곳이었고, 학과별 결과를 합치면 오히려 여성에게 약간 유리했다. 논문의 설명은 “여성 지원자 비율은 합격하기 어려운 학과에서 높고 쉬운 학과에서 낮은 경향이 있다”는 것이다. 44% 대 35%는 틀린 숫자가 아니다. 틀릴 수 있는 것은 거기서 바로 뽑은 결론이다.
그래프 그 자체로 결론을 설명할 수 있게 한다
책은 그래프를 효과적으로 쓰면 그래프 자체가 결론을 설명할 수 있다고 본다. 이 말을 실무 기준으로 옮기면 두 가지다.
- 그래프 제목에 결론을 쓴다. “월별 매출 추이”는 주제이고 “3월 이후 매출이 줄고 있다”는 결론이다.
- 결론에 필요 없는 요소를 뺀다. 강조할 막대 하나만 색을 넣고 나머지는 회색으로 둔다.
책이 드는 구체적인 방법 하나는 내림차순 정렬이다. 근거를 찾아보니 정렬의 효과를 직접 잰 실험은 찾지 못했다. Stephen Few의 안내처럼 “큰 값을 강조하려면 내림차순으로 정렬한다”는 전문가의 권고 수준이다(Perceptual Edge, 2004-09-18). 그래도 효과는 직접 그려 보면 바로 보인다. 내 블로그의 글별 노출 수다.
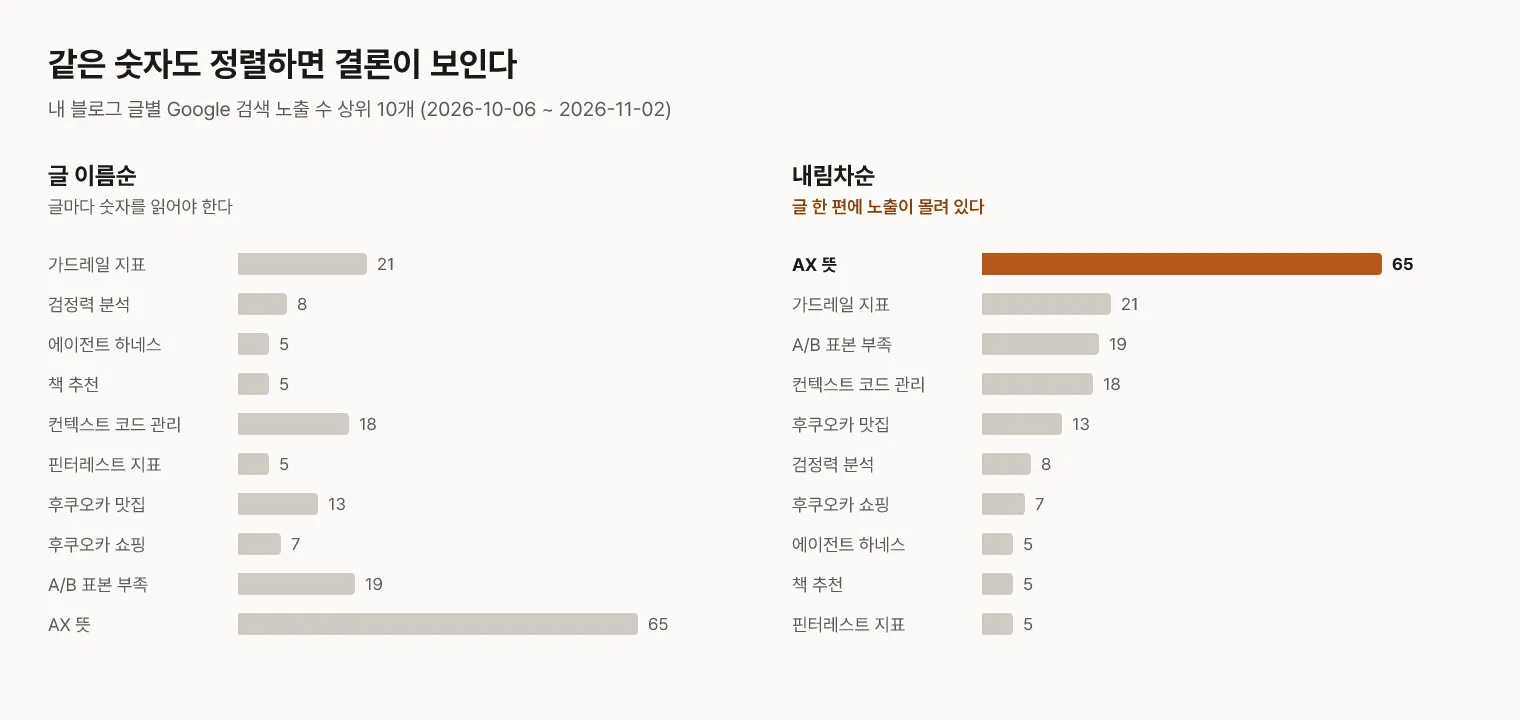
왼쪽은 결과이고 오른쪽은 결론에 가깝다. 이 그림이 왜 중요한지는 뒤의 내 블로그 절에서 다시 나온다.
결론을 낼 때 주의해야 할 세 가지
1. 필요 이상의 해석을 덧붙이지 않는다
첫 번째 질문은 “데이터로 설명 가능한 범위인가?”다. 어떤 데이터를 통해 알 수 있는지를 의식하며 자가 점검을 하지 않으면, 데이터로 설명할 수 있는 범위에서 벗어나기 쉽다.
사례: Bing에서는 버그가 지표를 올렸다. Bing의 한 실험에서 버그 때문에 사용자에게 아주 나쁜 검색 결과가 나갔다. 그런데 핵심 지표는 좋아졌다. 사용자당 고유 검색 수가 10% 넘게, 사용자당 매출이 30% 넘게 올랐다(Kohavi et al., KDD 2012). 원하는 답을 못 찾은 사람이 검색을 더 하고 광고를 더 누른 것이다. “지표가 올랐다”는 결과에 “그러니 좋아졌다”는 해석을 붙였다면 일부러 품질을 낮춰야 한다는 결론이 나온다. 논문도 그렇게 지적한다. Bing은 이후 세션 수를 핵심 지표로 삼고, 검색 수만으로 실험을 평가하지 말라고 권고했다.
같은 저자들은 “흥미롭거나 달라 보이는 숫자는 대개 틀렸다”는 트와이먼의 법칙(Twyman’s law)을 실무 규칙으로 소개한다(Kohavi et al., KDD 2014). 해석을 덧붙이기 전에 측정이 맞는지부터 의심하라는 뜻이다. 이 논문의 사례 중에는 JavaScript를 추가했더니 Bing 클릭이 늘어난 일도 있었다. 실제 클릭이 늘어난 것이 아니라 클릭 추적이 정확해진 결과였다.
사례: Wald의 비행기는 이야기 자체가 덧붙여졌다. 생존 편향을 설명할 때 빠지지 않는 일화가 있다. 군이 돌아온 폭격기의 총탄 구멍을 보고 구멍이 많은 곳을 보강하려 하자, 통계학자 Abraham Wald가 구멍이 없는 곳을 보강하라고 했다는 이야기다.
원리는 맞다. Mangel과 Samaniego의 표현대로 “지휘관은 돌아오지 못한 항공기의 피탄 분포를 알지 못한다”(JASA, 1984). 돌아온 비행기 데이터로 말할 수 있는 범위에는 한계가 있다.
그런데 일화는 원문보다 부풀어 있다. 1943년 Wald 메모의 재간행본을 보면 내용은 대부분 수학 모형이고 숫자는 가상 예시다. “구멍 없는 곳에 장갑을 대라”는 권고는 찾을 수 없다. 장갑은 “방호 장갑 위치를 정하는 지침으로 쓸 수 있다”는 말로 한 번 나온다(CNA 재간행본, 1980). 군의 판단을 전하는 문장은 W. Allen Wallis가 1980년 회고의 답변문에 쓴 것이다. 수학자 Bill Casselman은 이 일을 추적한 뒤 Wallis의 회고와 Wald의 메모에 없는 내용은 “사실이 아니라 허구로 봐야 한다”고 정리했다(AMS Feature Column, 2016-06). 유명한 비행기 그림도 2016년 위키미디어에 올라온 것이다.
필요 이상의 해석을 경고하는 일화가 필요 이상의 해석으로 전해지고 있는 셈이다.
2. 인지 편향(선입견)을 의심한다
책의 문장을 옮기면 이렇다.
데이터는 직접 자신이 보거나 경험한 것 이외의 세상을 간접적으로 보여주는 편리한 도구지만, 데이터가 나타내는 것이 세상의 전부라 할 수는 없습니다.
Daniel Kahneman은 같은 현상에 WYSIATI, “보이는 것이 전부다(what you see is all there is)“라는 이름을 붙였다. 좋은 이야기에 중요한 것은 정보의 완전성이 아니라 일관성이라는 것이다(『Thinking, Fast and Slow』 7장, 2011). 데이터가 깔끔한 이야기를 만들어 주면 빠진 것을 묻지 않게 된다.
사례: 숫자를 읽을 줄 알아도 선입견은 작동한다. Dan Kahan 연구팀은 미국 성인 1,111명에게 같은 2×2 표를 보여 줬다(Kahan et al., Behavioural Public Policy, 2017). 숫자는 모두 같고 제목만 달랐다. 어떤 사람에게는 피부 크림의 효과로, 어떤 사람에게는 총기 휴대 금지의 효과로 보여 줬고, 조건에 따라 열 제목을 바꿔 정답이 뒤집히게 했다. 아래는 그중 한 버전이다.
| 좋아짐 | 나빠짐 | 좋아진 비율 | |
|---|---|---|---|
| 처치함 | 223 | 75 | 74.8% |
| 처치 안 함 | 107 | 21 | 83.6% |
절대 숫자만 보면 처치군이 커 보이지만, 비율을 계산하면 처치군이 더 나쁘다. 표가 피부 크림일 때보다 총기 규제일 때 응답이 정치 성향에 따라 갈렸고 정확도도 떨어졌다. 연구팀은 숫자에 강한 사람일수록 이 양극화가 오히려 커졌다고 보고했다.
여기서도 범위를 지켜야 한다. 원저자들이 검토한 사전등록 재현 연구(n=3,154)는 “동기화된 수리력에 대한 좋은 증거를 찾지 못했다”고 결론 내렸다(Persson et al., Cognition, 2021). 정리하면 “자기 입장에 맞는 쪽으로 답하는 경향”은 재현됐지만 “수리력이 높으면 그 경향이 더 커진다”는 강한 주장은 재현되지 않았다. 말할 수 있는 것은 “숫자를 읽을 줄 안다고 선입견이 사라지지는 않는다”까지다.
3. 정답은 역시 한 가지가 아니다
같은 데이터와 같은 질문이어도 결론은 하나로 모이지 않는다. 이 말은 비유가 아니라 측정된 사실이다.
| 연구 | 설계 | 결과 |
|---|---|---|
| Silberzahn et al., 2018 | 29팀, 같은 축구 데이터로 “피부색이 어두운 선수가 레드카드를 더 받는가” | 20팀(69%) 유의, 9팀 유의하지 않음. 오즈비 0.89~2.93 |
| Breznau et al., 2022 | 73팀, 같은 설문으로 “이민이 늘면 사회정책 지지가 줄어드는가” | 모형 1,261개가 모두 달랐다. 결론 89건 중 54건 기각, 23건 지지, 12건 검정 불가 |
| Menkveld et al., 2024 | 164팀, 같은 선물 거래 데이터 7.2억 건 | 팀 간 결과의 퍼짐이 표준오차와 비슷한 크기. 동료 피드백 뒤 47.2% 감소 |
Silberzahn 연구는 팀들의 사전 믿음이나 전문성으로 이 차이를 설명하지 못했다. Breznau 연구도 식별한 분석 결정과 연구자 특성을 다 넣어도 결과 차이의 95% 이상이 설명되지 않았다. 누가 틀려서 생긴 차이가 아니라는 뜻이다. 분석에는 선택이 들어가고, 그 선택은 대부분 정당화할 수 있다.
Airbnb에서도 비슷한 일이 있었다. CEO가 지난주 예약이 가장 많은 도시를 물었을 때 데이터 사이언스팀과 재무팀이 서로 다른 테이블과 지표 정의를 써서 다른 답을 낸 적이 있다고 한다(Airbnb Tech Blog, 2021). 이 경우는 해석보다 지표 정의가 달랐던 사례다.
그렇다고 아무 결론이나 괜찮다는 말은 아니다. 내가 읽은 시사점은 세 가지다.
- 결론에 어떤 선택을 전제로 했는지 함께 쓴다.
- 결론이 달라질 수 있는 다른 분석을 하나 이상 돌려 본다.
- 발표 전에 다른 사람에게 보인다. Menkveld 연구에서 동료 피드백이 결과의 퍼짐을 절반 가까이 줄였다.
내 블로그에 적용해 보기
5장 글 끝에서 다음 할 일 두 가지를 정했다. GA4에서 유입 경로별 DAU를 나누는 일과, 글별 경과 일수와 순위를 비교하는 일이다. 유입 경로는 이번에도 확인하지 못했다. GA4 화면을 열지 못했기 때문이다. Search Console 숫자는 새로 뽑았다.
| 지표 | 2026-10-06 ~ 2026-11-02 (28일) |
|---|---|
| 클릭 | 8 |
| 노출 | 180 |
| CTR | 4.4% |
| 평균 게재 순위 | 16.3 |
이것은 결과다. 2장 글의 숫자(2026-09-20 ~ 10-12, 노출 72회, 순위 13.7)와 나란히 놓으면 결론이 금방 나올 것 같다. 그런데 같은 데이터로 세 가지가 나왔다.
| 읽는 방법 | 근거 | 문제 |
|---|---|---|
| 노출이 2.5배 늘었다 | 72회 → 180회 | 기간이 23일과 28일로 다르고 10월 6~12일이 겹친다 |
| 순위가 나빠졌다 | 13.7 → 16.3 | 평균 하나가 글 한 편에 끌렸을 수 있다 |
| 노출이 줄고 있다 | 주간 64 → 38 → 48 → 30회 | 주 30~60회대로는 우연과 구분하기 어렵다 |
세 문장 모두 숫자로는 맞다. 하지만 이대로 결론이라고 하면 앞에서 본 잘못을 그대로 하는 것이다.
그래서 그래프를 내림차순으로 놓고 다시 봤다. 앞의 그림에서 AX 뜻 글 한 편이 페이지별 노출 합계 212회 중 65회(31%)를 차지했다. 이 글의 평균 순위는 28.7이다. (전체 노출 180회와 페이지 합계 212회가 다른 것은 Search Console이 사이트 기준과 페이지 기준을 다르게 세기 때문이다.)
글을 필터링해서 보니 ‘ax’라는 한 단어 검색어에서 12회 노출됐고 순위는 79.2였다. ‘dx ax’는 90.5, ‘ax 뜻’도 한 번 83위로 나왔다. 반면 ‘ai+x 뜻’은 7위, ‘공공ax’는 9위였다. 페이지별 순위를 노출 수로 가중 평균하면 전체는 14.6이고, AX 글을 빼면 8.4다(내 계산이며 Search Console의 전체 평균과 계산 방식이 다르다). 페이지 27개 중 20개의 평균 순위는 10위 안이었다. 다만 그중 다수는 노출이 한 자릿수다.
여기서 5장 글의 내 문장을 고쳐야 한다. 나는 “평균 게재 순위가 13.7이라 대부분 검색 결과 2페이지에 있다”고 썼다. 평균 하나로 분포를 말한, 필요 이상의 해석이었다. 이번 28일을 보면 페이지 수로는 다수가 1페이지에 나오고, 노출이 몰린 글 한 편이 경쟁이 센 넓은 검색어의 뒤쪽 순위에서 평균을 끌어내린다.
이제 결과를 결론으로 바꿔 쓰면 이렇다.
결과: 최근 28일 노출 180회, 평균 순위 16.3.
결론: 블로그 전체의 순위가 낮다기보다, 노출의 약 3분의 1이 몰린 AX 글이 ‘ax’ 같은 넓은 검색어에서 뒤쪽 순위로 나오는 영향이 크다. 그래서 다음에 볼 것은 전체 평균이 아니라 AX 글의 검색어다.
데이터로 설명할 수 없는 것도 같이 적어 둔다.
- DAU와의 관계는 모른다. GA4를 못 봤으니 검색이 DAU에 얼마나 기여하는지는 말할 수 없다.
- 순위가 시간에 따라 오르는지는 아직 모른다. 이번 숫자는 28일 한 묶음이라 글별 추이가 아니다. 5장의 두 번째 할 일은 절반만 했다.
- AX 글 개편 효과는 판단하지 않는다. 10월 12일 개편 전후를 나눠 보지 않았다. 표에 보이는 AX 글의 검색어도 8개, 노출 합계 22회뿐이다. 나머지 43회의 검색어는 Search Console 화면에 나오지 않는다.
- 표본이 작다. 한 주 클릭이 0~5회다. 이 글의 결론도 다음 28일에 바뀔 수 있다.
마치며: 결론을 말하기 전에 던질 질문
리포트를 보내기 전에 아래 다섯 가지를 확인한다.
- 이 문장은 결과인가, 결론인가? “그래서 뭐?”라고 물었을 때 답이 나오는가.
- 결론이 맨 앞에 있는가? 제목이나 첫 문장만 읽어도 무엇을 해야 할지 알 수 있는가.
- 요약 숫자 뒤의 분포를 봤는가? 평균 하나로 전체를 말하고 있지 않은가. 그래프로 그리고 나눠 봤는가.
- 데이터로 설명할 수 있는 범위인가? 어떤 데이터로 그렇게 말할 수 있는지 문장마다 답할 수 있는가. 이 데이터에 없는 것은 무엇인가.
- 다른 결론도 가능한가? 어떤 선택을 전제로 했는지 적었는가. 다른 사람에게 보여 줬는가.
결론은 정답을 찾는 일이 아니다. 지금 가진 데이터로 말할 수 있는 만큼을 내 이름으로 말하는 일이다. 틀릴 수 있다. 그래서 무엇을 근거로, 어디까지 말하는지를 함께 적는다.
참고 자료
- 카시와기 요시키 (2021). 『빅데이터 시대, 성과를 이끌어 내는 데이터 문해력』 6장 ‘결론은 이것이다’ 정보를 요약하라. 강모희 옮김. 프리렉.
- Ranadive, A. (2013-08-17). Where’s the “So What?”. Medium.
- McKinsey Alumni News. Barbara Minto: “MECE: I invented it, so I get to say how to pronounce it”.
- Airbnb (2016). Knowledge Repo template. GitHub.
- Pettingill, L. M. (2019-03-12). Advice for new data scientists. Airbnb Tech Blog.
- Arsenault, M.-O. (2020-06-18). Shopify’s Data Science & Engineering Foundations. Shopify Engineering.
- Presidential Commission on the Space Shuttle Challenger Accident (1986-06-06). Report, Vol. 1, Chapter V, Chapter VI.
- Columbia Accident Investigation Board (2003-08). Report, Volume I.
- Anscombe, F. J. (1973). Graphs in Statistical Analysis. The American Statistician, 27(1).
- Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975-02-07). Sex Bias in Graduate Admissions: Data from Berkeley. Science, 187(4175).
- Few, S. (2004-09-18). Eenie, Meenie, Minie, Moe: Selecting the Right Graph for Your Message. Perceptual Edge.
- Kohavi, R., et al. (2012). Trustworthy Online Controlled Experiments: Five Puzzling Outcomes Explained. KDD ‘12.
- Kohavi, R., Deng, A., Longbotham, R., & Xu, Y. (2014). Seven Rules of Thumb for Web Site Experimenters. KDD ‘14.
- Wald, A. (1980 재간행, 원 메모 1943). A Method of Estimating Plane Vulnerability Based on Damage of Survivors. CNA, CRC 432.
- Mangel, M., & Samaniego, F. J. (1984). Abraham Wald’s Work on Aircraft Survivability. JASA, 79(386).
- Casselman, B. (2016-06). The Legend of Abraham Wald. AMS Feature Column.
- Kahneman, D. (2011). 『Thinking, Fast and Slow』 7장. Farrar, Straus and Giroux.
- Kahan, D. M., Peters, E., Dawson, E. C., & Slovic, P. (2017). Motivated numeracy and enlightened self-government. Behavioural Public Policy, 1(1).
- Persson, E., et al. (2021). A preregistered replication of motivated numeracy. Cognition, 214.
- Silberzahn, R., et al. (2018). Many Analysts, One Data Set. AMPPS, 1(3).
- Breznau, N., et al. (2022-10-28). Observing many researchers using the same data and hypothesis reveals a hidden universe of uncertainty. PNAS, 119(44).
- Menkveld, A. J., et al. (2024). Nonstandard Errors. The Journal of Finance, 79(3).
- Chang, R., et al. (2021-04-30). How Airbnb Achieved Metric Consistency at Scale. Airbnb Tech Blog.