A/B 테스트에서 검정력 분석이 필요한 이유
A/B 테스트의 p-value를 믿으려면 실험 전에 검정력 분석으로 표본 크기를 정해야 합니다. 검정력의 정의, 표본 수 계산, Type S·M 오류, 사후 검정력의 함정, 실무 적용법을 정리했습니다.
목차
들어가며
결론부터: A/B 테스트의 p-value를 믿으려면, 실험을 시작하기 전에 검정력 분석으로 표본 크기를 정해 두어야 한다.
이 글은 방태모님의 발표 영상 온라인 통제 실험에서 검정력 분석이 필요한 이유를 보고 정리한 노트다. 검정력의 정의, 사전 검정력 분석으로 표본 수를 정하는 방법, 검정력이 낮을 때 생기는 Type S·Type M 오류, 사후 검정력 분석이 왜 의미 없는지, 그리고 실무에서 어떻게 적용할지를 순서대로 다룬다.
실무에서 자주 듣는 “일단 돌려보고 유의하면 배포하자”는 접근이 왜 위험한지가 이 글의 핵심 질문이다.
핵심 용어 정리
검정력 분석에 나오는 용어는 대부분 “가설검정의 네 가지 결과”와 “표본 수를 정하는 네 가지 값”으로 묶인다.
| 용어 | 기호 | 의미 | A/B 테스트 예시 |
|---|---|---|---|
| 귀무가설 | H0 | 두 그룹 간 차이가 없다 | 새 추천 로직의 CTR = 기존 CTR |
| 대립가설 | H1 | 두 그룹 간 차이가 있다 | 새 추천 로직의 CTR ≠ 기존 CTR (양측검정 기준) |
| 유의수준 | α | H0가 참인데 기각할 확률의 상한 (1종 오류, 거짓 양성) | 보통 0.05 |
| 1종 오류 | α | 효과가 없는데 있다고 판단 | 효과 없는 기능을 배포 |
| 2종 오류 | β | 효과가 있는데 없다고 판단 (거짓 음성) | 좋은 기능을 버림 |
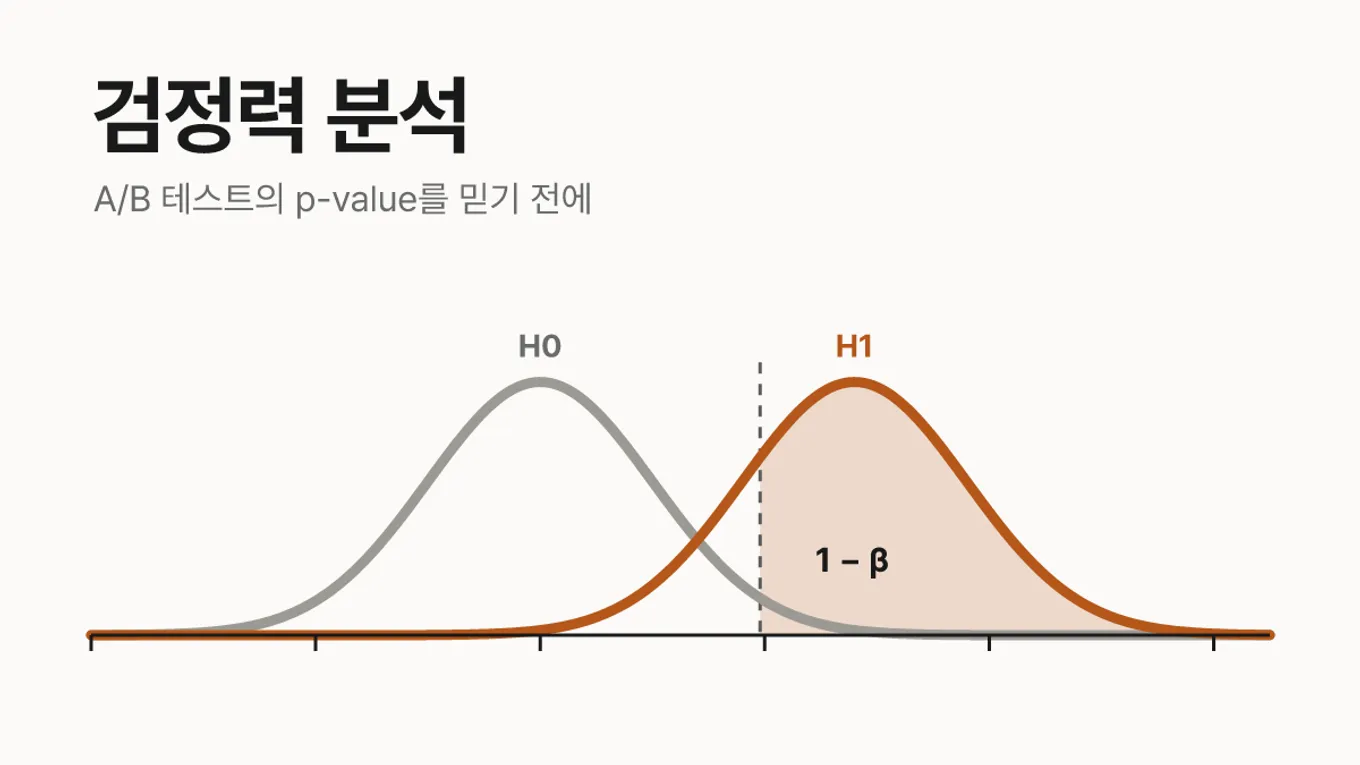
| 검정력 | 1 − β | 실제 효과가 있을 때 이를 탐지할 확률 | 보통 0.8 이상을 목표 |
| 효과 크기 | δ, d | 그룹 간 차이의 크기 (절대 차이, 상대 lift, 표준화된 Cohen’s d) | CTR 2.0% → 2.2% (+10% lift) |
| 최소 탐지 효과 | MDE | 실험이 탐지하도록 설계한 가장 작은 효과 | “+5% lift 미만은 의미 없다” |
| 분산 | σ² | 지표의 흩어진 정도, 클수록 표본이 더 필요 | 매출 지표는 CTR보다 분산이 큼 |
| 표본 크기 | n | 그룹당 필요한 관측 단위 수 | 그룹당 사용자 50,000명 |
| p-value | p | H0가 참일 때 관측값 이상으로 극단적인 결과가 나올 확률 | p = 0.03 |
| 사전 검정력 분석 | a priori | 실험 전에 α, 검정력, MDE로 n을 계산 | 설계 단계에서 수행 |
| 사후 검정력 분석 | post hoc, observed power | 관측된 효과로 실험 후 검정력을 계산 | 권장되지 않음 |
| Type S 오류 | Sign | 유의하게 나온 효과의 부호가 실제와 반대일 확률 | 실제는 −인데 +로 추정 |
| Type M 오류 | Magnitude | 유의하게 나온 효과가 실제보다 얼마나 부풀려졌는지 (과장 비율) | 실제 +2%인데 +8%로 추정 |
α와 1종 오류는 같은 기호를 쓰지만, α는 “허용하기로 정한 상한”이고 1종 오류는 “그 사건 자체”라는 점이 다르다.
검정력이란?
검정력은 두 그룹 사이에 실제 차이가 있을 때 그 차이를 통계적으로 유의하다고 올바르게 탐지할 확률, 즉 1 − β다.
가설검정의 결과는 “실제 효과가 있는가”와 “검정이 유의하게 나왔는가”의 조합으로 네 가지가 된다.
| H0 기각 (유의함) | H0 채택 (유의하지 않음) | |
|---|---|---|
| 실제 효과 없음 (H0 참) | 1종 오류, 확률 α | 올바른 판단, 확률 1 − α |
| 실제 효과 있음 (H1 참) | 올바른 탐지, 확률 1 − β (검정력) | 2종 오류, 확률 β |
검정력은 네 가지 값이 함께 결정한다. 하나를 정하면 나머지 셋 중 하나가 따라 움직인다.
- 표본 크기 n: 클수록 검정력이 올라간다.
- 효과 크기 δ: 실제 차이가 클수록 탐지가 쉽다.
- 분산 σ²: 지표의 노이즈가 클수록 검정력이 떨어진다.
- 유의수준 α: α를 엄격하게(작게) 잡을수록 검정력이 떨어진다.
검정력 0.8은 “효과가 정말 있어도 10번 중 2번은 놓친다”는 뜻이다. 검정력이 낮은 실험에서는 유의한 결과가 나와도, 그 결과가 우연한 노이즈에 크게 기대고 있을 가능성이 높다.
검정력 분석
검정력 분석은 원하는 검정력을 확보하는 데 필요한 최소 표본 수를 계산하는 과정이며, 반드시 실험 전(a priori)에 수행한다.
입력은 세 가지, 출력은 하나다.
- 유의수준 α를 정한다 (예: 0.05, 양측).
- 목표 검정력 1 − β를 정한다 (예: 0.8).
- MDE와 지표의 분산을 정한다 (과거 데이터에서 추정).
- 그룹당 필요한 표본 크기 n을 계산한다.
두 그룹 평균 비교(양측, 그룹 크기 동일)의 근사식은 다음과 같다. 이 글의 수식과 예시는 모두 양측검정 기준이며, 단측검정이라면 z₁₋α/₂ 대신 z₁₋α를 쓴다.
n(그룹당) = 2 × (z₁₋α/₂ + z₁₋β)² × σ² / δ²α = 0.05, 검정력 0.8이면 분자의 상수는 2 × (1.96 + 0.84)² ≈ 15.7이므로, 실무에서는 n ≈ 16σ² / δ²라는 경험식으로 빠르게 어림하기도 한다.
계산 예시: 전환율 지표는 σ² = p(1 − p)로 둔다. 기준 CTR 2.0%에서 상대 +10%(절대 0.2%p)를 탐지하려면 σ² = 0.02 × 0.98 ≈ 0.0196, δ = 0.002이고, n ≈ 15.7 × 0.0196 / 0.002² ≈ 76,900, 즉 그룹당 약 77,000명이 필요하다.
식에서 바로 보이는 점: n은 δ²에 반비례한다. MDE를 절반으로 줄이면 필요한 표본은 4배가 된다. 그래서 “작은 효과까지 잡고 싶다”는 요구는 곧 “트래픽과 기간을 훨씬 더 쓰겠다”는 결정이다.
검정력이 낮은 실험의 위험
검정력이 낮은 실험의 진짜 문제는 “효과를 놓친다”보다 “유의하게 나온 결과가 틀린 방향이거나 부풀려져 있다”는 데 있다.
이 관점은 Gelman & Carlin(2014)이 제안한 두 가지 오류로 정리된다.
- Type S 오류 (Sign): 유의하게 나온 추정치의 부호가 실제 효과와 반대일 확률이다. 실제로는 새 기능이 지표를 조금 떨어뜨리는데, 실험 결과는 “유의하게 올랐다”로 나오는 경우다.
- Type M 오류 (Magnitude): 유의하게 나온 추정치가 실제 효과보다 몇 배 큰지를 나타내는 과장 비율(exaggeration ratio)이다. 실제 lift는 +1%인데 보고된 lift는 +5%인 경우다.
왜 이런 일이 생기는가: 표본이 작으면 추정치의 표준오차가 크다. 이때 유의성 문턱을 넘으려면 추정치가 우연히 크게 튀어야 한다. 그래서 “유의함”이라는 필터를 통과한 결과만 모으면, 실제보다 큰 값이나 반대 부호의 값이 과대 대표된다 (승자의 저주와 같은 구조).
같은 계산을 검정력 전체 구간으로 넓히면, 검정력이 낮을수록 유의한 결과의 과장 비율이 가파르게 커진다. 검정력 0.8에서는 약 1.1배지만, 0.17에서는 약 2.5배다.
실무 영향: 과장된 lift를 근거로 기능을 배포하면, 배포 후 실제 지표 개선은 기대보다 훨씬 작거나 없다. 이런 경험이 쌓이면 실험 결과 전체에 대한 조직의 신뢰가 떨어진다.
사후 검정력 분석의 함정
관측된 효과 크기로 실험 후에 검정력을 계산하는 사후 검정력(observed power)은 새로운 정보를 주지 않으며 신뢰할 수도 없다.
이유는 세 가지다.
- p-value의 재포장일 뿐이다: 사후 검정력은 같은 데이터의 관측 효과와 표준오차로 계산하므로 p-value와 일대일로 대응한다 (Hoenig & Heisey, 2001). 양측 p = 0.05이면 사후 검정력은 약 0.5이고, p가 클수록 사후 검정력은 낮게 나온다.
- 결론이 미리 정해져 있다: 유의하지 않은 결과는 거의 항상 “검정력이 낮았다”로 나온다. 따라서 “유의하지 않은 건 검정력 부족 때문”이라는 해석은 순환 논리다.
- 노이즈가 크다: 입력값인 관측 효과 자체가 표본 변동에 크게 흔들린다. 특히 표본이 작은 실험일수록 관측 효과는 실제 효과에서 멀어지고, 그 위에서 계산한 검정력도 함께 흔들린다.
결과가 유의하지 않을 때 대신 볼 것: 효과 추정치의 신뢰구간이다. 구간이 MDE를 포함하지 않을 만큼 좁다면 “의미 있는 크기의 효과는 없다”고 말할 수 있고, 구간이 넓다면 “이 실험으로는 판단할 수 없다”고 말해야 한다.
실무 제언
분산과 효과 크기를 모를 때도 검정력 분석은 생략하지 말고, 추정치를 구하는 방법을 바꿔야 한다.
입력값을 구하는 방법
- 과거 데이터: 같은 지표의 최근 몇 주 데이터로 분산을 추정한다. 온라인 서비스는 대부분 이 데이터를 이미 가지고 있다.
- 과거 실험과 연구: 비슷한 기능의 이전 실험에서 나온 효과 크기를 MDE의 참고값으로 쓴다. 단, 그 값도 Type M 오류로 부풀려졌을 수 있으니 보수적으로 잡는다.
- 파일럿 테스트: 사전 데이터가 전혀 없다면 소규모 파일럿으로 분산을 먼저 추정한다. 파일럿의 효과 추정치는 노이즈가 크므로 효과 크기가 아니라 분산 추정에 쓴다.
- 비즈니스 기준: MDE는 “통계적으로 기대되는 효과”가 아니라 “이 정도는 되어야 배포할 가치가 있는 효과”로 정하는 것이 실무적으로 자연스럽다.
온라인 실험에서 표본 크기를 확보하는 방법
- 트래픽 배분 조절: 실험군 비율을 높이면 같은 기간에 더 많은 표본을 모은다. 대신 위험한 변경이라면 노출 범위와 리스크를 함께 저울질한다.
- 실험 기간 조절: 필요한 n을 일일 유입량으로 나눠 기간을 정한다. 요일 효과를 고려해 최소 1주 단위로 잡는 것이 일반적이다.
- 분산 줄이기: CUPED처럼 실험 전 데이터로 분산을 줄이면 같은 n으로 더 높은 검정력을 얻는다.
- 지표 선택: 매출처럼 분산이 큰 지표 대신, 민감도가 높은 대리 지표(전환율, 클릭률)를 주요 지표로 고려한다.
조기 중단 주의: 표본 크기를 정해 놓고도 매일 p-value를 보다가 유의해지는 순간 멈추면(peeking) 1종 오류율이 크게 늘어난다. 정해진 n에 도달할 때까지 기다리거나, 순차 검정 방법을 쓴다. n에 먼저 도달하더라도 요일 효과를 반영하도록 1주 또는 2주 같은 완결된 주기를 채운 뒤 종료한다.
표본을 충분히 확보하지 못할 때
트래픽이 부족하면 표본 수를 늘릴 수 없으니, MDE를 키우거나 분산을 줄이거나 판단 기준을 바꾸는 쪽으로 설계를 조정해야 한다. 아래 방법마다 실제 표본 절감 수치와 한계는 표본이 충분하지 않을 때 실험은 어떻게 해야 할까?에서 자세히 다뤘다.
먼저 MDE와 필요한 표본 수의 관계를 보면 왜 “과감한 변경”이 유리한지 보인다. 기준 CTR 2.0%, α = 0.05(양측), 검정력 0.8일 때의 근사값이다.
| 목표 상대 lift | 절대 차이 δ | 그룹당 필요 표본 (근사) |
|---|---|---|
| +10% | 0.2%p | 약 77,000명 |
| +30% | 0.6%p | 약 8,500명 |
| +50% | 1.0%p | 약 3,100명 |
| +100% | 2.0%p | 약 770명 |
표본이 적을 때 쓸 수 있는 방법:
- MDE를 키운다: 버튼 색이나 폰트 크기 같은 작은 변경 대신, 메인 카피 전면 교체나 핵심 기능 추가처럼 큰 효과를 기대할 수 있는 변경을 실험 대상으로 고른다.
- 분산을 줄인다: CUPED처럼 실험 전 행동 데이터를 공변량으로 써서 지표 분산을 줄이면, 같은 표본으로 더 작은 효과를 잡을 수 있다.
- 더 민감한 지표를 쓴다: 구매 전환처럼 드문 이벤트 대신, 클릭이나 다음 단계 진입처럼 발생 빈도가 높은 퍼널 상단 지표를 주요 지표로 둔다.
- 실험 기간을 늘린다: 일일 유입이 적어도 기간을 늘리면 n은 모인다. 다만 기간이 길수록 시즌 변화와 쿠키 이탈 같은 오염이 커진다.
- 판단 기준을 명시적으로 조정한다: 되돌리기 쉬운 변경이라면 α를 0.1로 완화하거나, 사전에 정한 방향만 보는 단측검정을 쓸 수 있다. 이 선택은 반드시 실험 전에 문서로 남긴다.
- 다른 설계를 고려한다: 사용자 단위 대신 세션·페이지뷰 단위로 무작위 배정하거나(독립성 가정 확인 필요), 베이지안 접근으로 “B가 A보다 나을 확률”과 기대 손실을 보고 결정하는 방법도 있다.
- 실험이 아닌 방법을 쓴다: 표본이 정말 부족하면 사용성 테스트, 인터뷰, 전후 비교 같은 정성·준실험 방법으로 판단하고, A/B 테스트는 트래픽이 생긴 뒤로 미룬다.
주의할 점: “큰 변경만 실험한다”는 전략도 실제 효과가 작으면 소용이 없다. 큰 효과를 기대했지만 실제 효과가 작은 상태에서 유의한 결과가 나왔다면, 그 추정치는 Type M 오류로 부풀려졌을 가능성이 높다. 기대 효과는 바람이 아니라 과거 실험이나 근거로 잡아야 한다.
마치며: 실험 설계 체크리스트
검정력 분석은 통계 절차라기보다, 실험 결과를 믿을 수 있게 만드는 설계 단계의 약속이다.
- 주요 지표와 MDE를 실험 전에 정했다
- 과거 데이터나 파일럿으로 지표의 분산을 추정했다
- α와 목표 검정력(보통 0.05, 0.8)을 정했다
- 그룹당 필요한 표본 수와 실험 기간을 계산했다
- 정해진 표본에 도달하기 전에 결과를 보고 멈추지 않기로 했다
- 유의하지 않은 결과는 사후 검정력이 아니라 신뢰구간으로 해석한다
- 유의한 결과라도 검정력이 낮았다면 효과 크기가 부풀려졌을 가능성을 함께 적는다
참고 문헌
- Gelman, A., & Carlin, J. (2014). Beyond Power Calculations: Assessing Type S (Sign) and Type M (Magnitude) Errors. Perspectives on Psychological Science.
- Hoenig, J. M., & Heisey, D. M. (2001). The Abuse of Power: The Pervasive Fallacy of Power Calculations for Data Analysis. The American Statistician.
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy Online Controlled Experiments. Cambridge University Press. 번역서 소개와 함께 읽을 책은 데이터 분석가 책 추천에 정리했다.