에이전트 하네스: 모델은 판단, 하네스는 실행
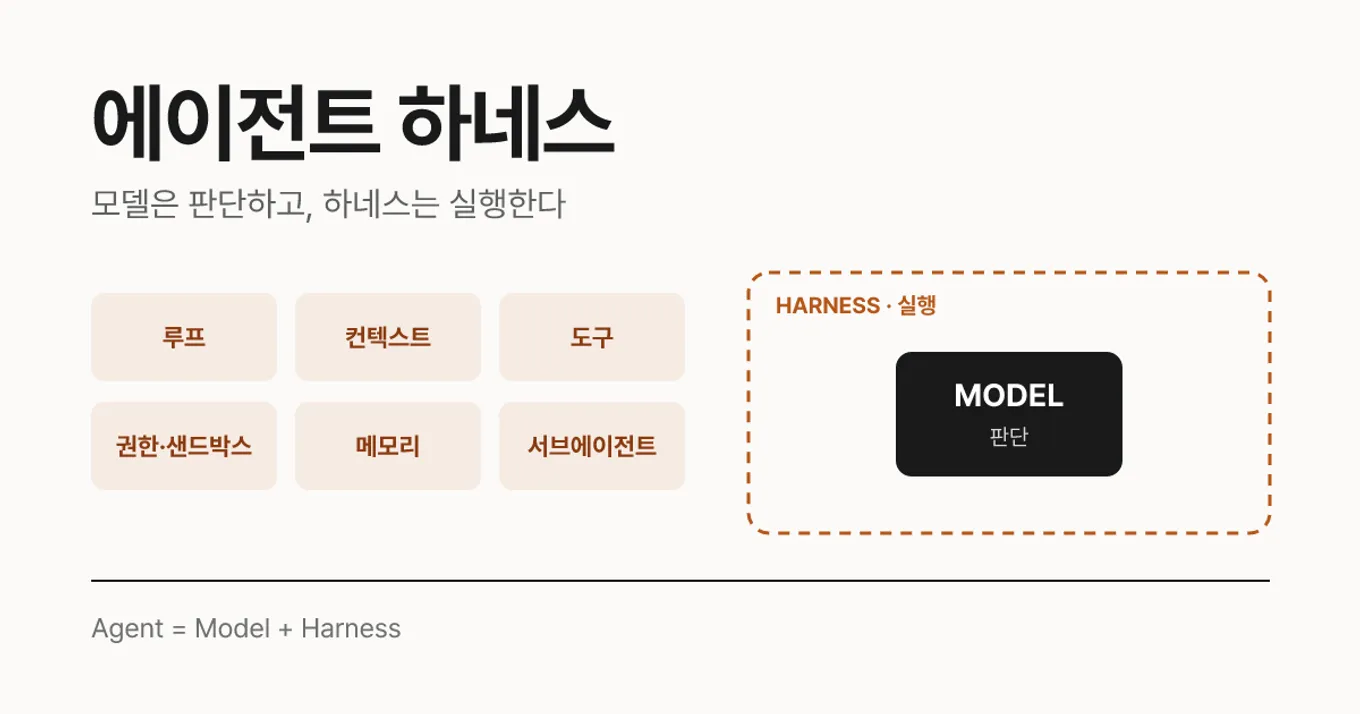
에이전트 하네스는 LLM을 에이전트로 만드는 바깥 구조입니다. 루프, 컨텍스트, 도구, 권한, 메모리, 서브에이전트까지 하네스가 하는 일과 모델을 바꾸지 않고 성능을 올린 사례를 정리했습니다.
목차
들어가며
결론부터: LLM이 도구를 쓸 수 있다고 에이전트가 되는 건 아니다. 모델은 무엇을 할지 판단할 뿐이고, 그 판단을 실제로 실행하고 결과를 다시 모델에게 돌려주는 바깥 구조가 따로 있다. 이 구조를 **에이전트 하네스(agent harness)**라고 부른다.
이 글은 Threads에서 본 @techwith.ram의 게시물에서 시작했다. 데이터 사이언스 교육 계정인데, 본문이 짧고 명확하다.
The model does the reasoning and decides what needs to happen. The agent harness is what actually connects everything together. Model = decides / Harness = executes
모델은 판단하고, 하네스는 실행한다. 이 글에서는 게시물에 붙은 16초짜리 인포그래픽의 6가지 구성 요소를 뼈대로, LangChain과 Anthropic이 공개한 하네스 자료와 실제 사례를 함께 정리했다.
에이전트 = 모델 + 하네스
LangChain의 Vivek Trivedy는 2026년 3월 글 The Anatomy of an Agent Harness에서 이 관계를 한 줄로 정리했다.
Agent = Model + Harness. If you’re not the model, you’re the harness.
모델이 아닌 것은 전부 하네스다. 시스템 프롬프트, 도구와 그 설명, 파일 시스템과 샌드박스, 서브에이전트를 띄우고 넘기는 로직, 압축(compaction)이나 검사를 강제하는 훅까지 모두 포함된다.
익숙한 도구로 보면 쉽다. Claude Code, Codex CLI, Cursor의 에이전트 모드는 모두 하네스다. Anthropic은 Claude Agent SDK를 “코딩뿐 아니라 도구로 맥락을 모으고, 계획하고, 실행해야 하는 작업에 능한 범용 에이전트 하네스”라고 소개한다. 같은 Claude 모델이라도 채팅창에서는 답 한 번으로 끝나고, Claude Code 안에서는 작업이 끝날 때까지 파일을 읽고 고치고 테스트를 돌린다. 차이는 모델이 아니라 하네스에 있다.
하네스가 하는 6가지 일
원 게시물의 인포그래픽은 하네스의 역할을 6개 패널로 나눴다. 하나씩 보자.
1. 루프: 생각하고, 실행하고, 관찰하기
모델은 텍스트만 쓴다. “bash로 pytest를 실행해 줘”라는 출력을 내놓을 뿐, 실제로 실행하지는 못한다. 하네스가 그 요청을 실행하고 결과를 다시 모델에게 넣어 준다. 인포그래픽은 이걸 “6줄짜리 하네스”로 보여준다.
while not done: out = llm(ctx) # 모델이 다음 행동을 고른다 if out.tool_call: r = run(out) # 하네스가 도구를 실행하고 ctx.append(r) # 결과를 컨텍스트에 붙여 다시 묻는다 else: return out # 도구 호출이 없으면 끝에이전트의 핵심은 이 루프다. 모델에게 한 번 묻고 끝나는 게 아니라, 도구 호출이 없어질 때까지 돌린다.
2. 컨텍스트: 모델이 무엇을 보는가
하네스는 매 턴 프롬프트를 다시 만든다. 시스템 프롬프트, 도구 스키마, 메모리 파일, 대화, 도구 결과가 한 창에 들어가고, 창이 한도에 가까워지면 오래된 턴을 요약으로 바꾼다. 무엇을 넣고 무엇을 뺄지 정하는 일이 컨텍스트 엔지니어링이고, 그걸 실제로 수행하는 곳이 하네스다.
3. 도구: 스키마를 주고 JSON을 받는다
도구 하나는 이름, 설명, JSON 스키마로 이뤄진다. 모델이 그중 하나를 골라 {"name": "bash", "input": {"command": "pytest"}} 같은 호출을 내면, 하네스가 실행하고 exit 0, 42 passed 같은 결과를 돌려준다. MCP 서버를 붙이는 것도 하네스에 도구를 추가하는 일이다.
4. 권한과 샌드박스
모든 도구 호출은 정책 검사를 거친다. 파일 읽기는 바로 실행하고, 위험한 쓰기는 사용자에게 먼저 묻고, 위험한 명령은 막는다. 실행 자체도 파일과 네트워크가 제한된 샌드박스 안에서 한다. Claude Code에서 “이 명령을 실행할까요?”라고 묻는 창이 바로 이 층이다.
5. 메모리: 컨텍스트보다 오래 남는 것
컨텍스트는 세션마다 초기화된다. 그래서 하네스는 할 일 파일이나 메모리 파일처럼 세션이 끝나도 남는 저장소를 둔다. 에이전트가 세션이 끝나기 전에 메모를 남기고, 다음 세션은 그 메모를 읽고 이어서 일한다.
6. 서브에이전트: 일을 나눈다
리드 에이전트가 “코드 검색”, “문서 읽기”, “테스트 실행” 같은 일을 서브에이전트에게 맡긴다. 각 서브에이전트는 깨끗한 컨텍스트에서 일하고 짧은 요약만 돌려준다. 리드 에이전트의 컨텍스트는 작게 유지된다.
인포그래픽의 마지막 줄이 이 모든 걸 요약한다. 같은 작업, 같은 모델이라도 모델만 있으면 답이 한 번, 에이전트는 끝날 때까지 간다.
같은 모델, 다른 하네스
하네스가 정말 그렇게 중요할까? 두 가지 사례가 답한다.
LangChain: 하네스만 바꿔 52.8% → 66.5%. LangChain은 2026년 2월 Improving Deep Agents with harness engineering에서 코딩 에이전트의 모델을 gpt-5.2-codex로 고정한 채 하네스만 고쳤다. 그 결과 Terminal Bench 2.0 점수가 52.8%에서 66.5%로 13.7점 올랐고, 순위는 30위권 밖에서 5위권으로 올라갔다. 바꾼 것은 이런 것들이다.
| 바꾼 것 | 하는 일 |
|---|---|
| 자기 검증 루프 | 계획 → 구현 → 테스트 실행 → 원래 요구사항과 비교 → 수정 순서로 일하게 유도 |
| 종료 전 체크리스트 | 에이전트가 끝내려 할 때 가로채 요구사항 대비 검증을 한 번 더 돌림 |
| 환경 파악 | 시작할 때 디렉터리 구조와 쓸 수 있는 도구를 먼저 정리해 줌 |
| 반복 감지 | 같은 파일을 계속 고치면 “접근 방식을 다시 생각해 보라”고 개입 |
| 추론량 배분 | 계획과 검증 단계에는 추론을 많이, 구현 단계에는 보통으로 |
Anthropic: 여러 세션에 걸친 긴 작업. Anthropic은 2025년 11월 Effective harnesses for long-running agents에서, 아무리 뛰어난 모델도 여러 컨텍스트 창에 걸친 큰 작업에서는 꾸준히 진척을 내기 어렵다고 썼다. 새 세션은 이전 작업을 기억하지 못하기 때문이다. 그래서 하네스를 두 단계로 나눴다.
- 초기화 에이전트: 첫 세션에서 실행 스크립트(
init.sh), 진행 기록 파일, 첫 git 커밋을 만든다. 200개가 넘는 기능 목록을 전부 “실패” 상태로 적어 둔다. - 코딩 에이전트: 이후 세션마다 조금씩 진척을 내고, git 커밋과 진행 기록을 남긴다.
흥미로운 디테일이 있다. 기능 목록을 마크다운이 아니라 JSON으로 만들었는데, 모델이 JSON 파일은 마크다운보다 함부로 고쳐 쓰는 일이 적었기 때문이라고 한다. 또 브라우저 자동화 도구를 줘서 직접 화면을 확인하게 하자, 코드만 봐서는 드러나지 않던 버그를 찾아냈다.
하네스에서 놓치기 쉬운 3가지
원 게시물의 답글과 위 사례를 겹쳐 보면, 하네스를 만들 때 놓치기 쉬운 지점이 세 가지 보인다.
1. 완료 판정을 모델에게 맡기지 않는다. 한 답글은 “모델이 끝났다고 할 때 루프를 끝내면, 채점 대상이 스스로 합격 점수를 매기는 셈”이라고 지적했다. Anthropic이 관찰한 실패 유형에도 “너무 일찍 완료를 선언함”, “테스트 없이 기능을 완료로 표시함”이 들어 있다. 그래서 하네스가 실제 상태(테스트 통과, 요구사항 충족)로 완료를 확인하고, 최대 반복 횟수를 안전장치로 둔다. LangChain의 종료 전 체크리스트도 같은 발상이다.
2. 잊는 것도 하네스의 일이다. 다른 답글은 하네스의 가장 덜 주목받는 역할로 “잊기”를 꼽았다. 오래된 파일 읽기 결과, 로그, 도구 결과 중 무엇을 버리고 언제 요약하고 무엇을 남길지에 따라 비용과 답의 품질이 함께 달라진다. 컨텍스트 엔지니어링의 COMPRESS와 TRIM이 하네스 안에서 일어나는 지점이다.
3. 샌드박스는 직접 확인한다. 샌드박스 옵션을 켰는데도 작업 폴더 밖 파일 내용이 그대로 출력됐다는 답글도 있었다. 개인 경험담이라 일반화할 수는 없지만, 권한과 샌드박스 설정은 켜 두는 것만으로 믿지 말고 실제로 막히는지 한 번 시험해 보는 게 맞다.
이 블로그의 하네스
이 블로그에는 매일 아침 데이터·AI 글감을 모아 디스코드로 보내는 작은 자동화가 있다. 지금 보면 이것도 하네스 위에 하네스를 하나 더 얹은 구조다. Claude Code(claude -p)가 안쪽 하네스이고, 그걸 감싸는 셸 스크립트가 바깥 하네스다.
| 하네스 요소 | 아침 글감 브리핑에서 |
|---|---|
| 루프 | Claude Code가 Aside 브라우저로 사이트를 하나씩 열고, 결과를 보고 다음 사이트로 넘어감 |
| 컨텍스트 | 키워드 파일에서 data·ai 행만 읽게 하고, 오늘 날짜와 제외할 URL 목록을 프롬프트 끝에 붙임 |
| 도구 | Aside 브라우저 실행, 메모리 검색, 파일 읽기 |
| 권한 | 허용 도구 5개 외에는 쓸 수 없고, 디스코드 전송 권한은 모델에게 주지 않고 스크립트가 직접 보냄 |
| 메모리 | 이미 보낸 URL 목록과 날짜별 브리핑 파일. 다음 날 실행과 후속 작업이 이걸 읽음 |
| 완료 판정 | 모델이 아니라 스크립트가 판단. 디스코드 전송이 모두 성공했을 때만 “오늘 보냄”으로 기록 |
이 브리핑에서 발견한 글감 중 하나가 AX의 두 가지 뜻이었다. 그중 Agent Experience는 에이전트가 쓰기 좋은 제품을 만드는 일이니, 결국 남의 하네스가 내 제품을 잘 쓰게 만드는 일이라고 볼 수도 있다.
마치며
- 에이전트 = 모델 + 하네스. 모델은 판단하고, 하네스는 실행한다. 모델이 아닌 것은 전부 하네스다.
- 하네스는 루프, 컨텍스트, 도구, 권한·샌드박스, 메모리, 서브에이전트를 맡는다.
- 모델을 그대로 두고 하네스만 바꿔도 성능이 크게 달라진다. LangChain은 하네스만 고쳐 벤치마크 점수를 13.7점 올렸다.
- 완료 판정은 하네스가 실제 상태로 하고, 무엇을 잊을지 설계하고, 샌드박스는 직접 시험한다.