컨텍스트도 코드처럼 관리하기
AI 에이전트에게 주는 컨텍스트를 코드처럼 버전 관리하고 평가하자는 InfoQ 발표를 정리했습니다. 생성, 평가, 배포, 관찰 네 단계와 컨텍스트 평가 방법, 작은 팀이 바로 해볼 것을 다뤘습니다.
목차
들어가며
결론부터: 에이전트에게 주는 컨텍스트도 코드처럼 만들고, 테스트하고, 배포하고, 운영에서 관찰해야 한다. 프롬프트 파일 하나를 고치는 일이 이제는 코드 한 줄을 고치는 것만큼 결과를 바꾸기 때문이다.
이 주장은 InfoQ에 올라온 QCon London 발표 Context is the New Code에서 가져왔다. 발표자 Patrick Debois는 DevOps 시절부터 개발 문화를 이야기해 온 사람이고, 지금은 Tessl에서 AI 네이티브 개발 패턴을 연구한다. 그는 2009년 DevOps가 던진 질문을 그대로 가져온다. 그때는 “운영이 개발처럼 되면?”이었고, 이번에는 “컨텍스트가 코드처럼 되면?”이다.
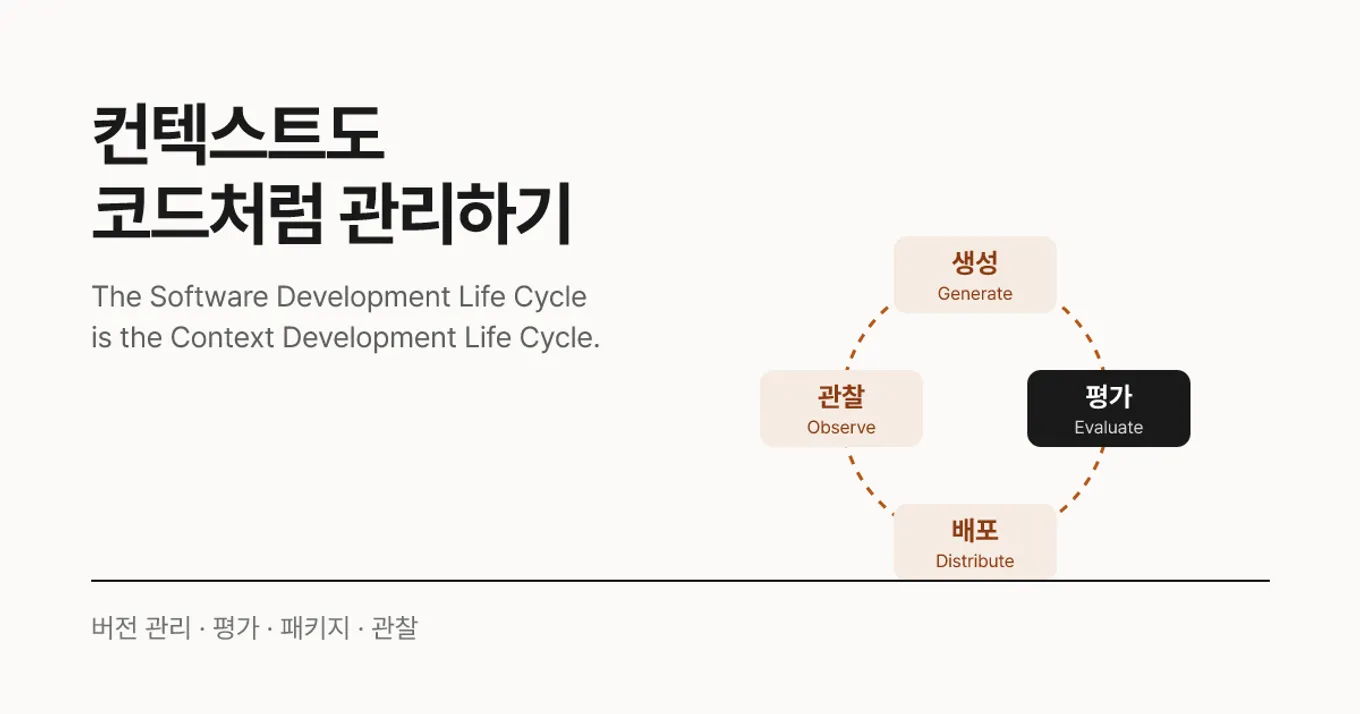
The Software Development Life Cycle is the Context Development Life Cycle.
이 블로그에서는 지금까지 컨텍스트를 두 번 다뤘다. 컨텍스트 엔지니어링은 창 안에 무엇을 넣을지, 링크드인의 데이터 컨텍스트 레이어는 회사 차원에서 컨텍스트를 어떻게 모으고 서빙할지였다. 이 글은 그 다음 질문, 컨텍스트를 어떻게 버전 관리하고 평가할지를 다룬다.
컨텍스트가 코드인 이유
발표자는 두 가지 근거를 든다. 하나는 바이브 코딩처럼 프롬프트와 컨텍스트가 실제로 코드를 만들어 낸다는 점이다. 다른 하나는 더 직접적이다. 그의 회사에서는 온보딩 과정의 수많은 예외 상황을 코드로 짜는 대신, 자연어로 쓴 스킬 하나로 대체했다.
So much code compressed to a couple of words. That’s also code.
몇 단어가 수많은 코드를 대신한다면, 그 몇 단어도 코드처럼 다뤄야 한다. 리뷰 없이 바꾸면 안 되고, 바꿨으면 테스트해야 하고, 누가 왜 바꿨는지 남아야 한다.
범위를 하나 짚어 두자. 발표자는 에이전트가 실행 중에 창 안에 무엇을 넣을지 정하는 일, 즉 좁은 의미의 컨텍스트 엔지니어링은 다루지 않는다고 했다. 이 발표의 대상은 미리 준비해 두는 산출물로서의 컨텍스트다. AGENTS.md나 CLAUDE.md 같은 지침 파일, 스킬, 팀 규칙, 라이브러리 문서 같은 것들이다.
발표는 이 산출물이 거치는 수명주기를 네 단계로 나눈다.
| 단계 | 하는 일 | 소프트웨어로 치면 |
|---|---|---|
| 생성 | 지침, 문서, 명세, 연결된 정보로 컨텍스트를 만든다 | 코드 작성 |
| 평가 | 컨텍스트가 실제로 작업을 더 잘 끝내게 하는지 테스트한다 | 테스트 |
| 배포 | 버전이 있는 패키지로 공유하고 보안·출처를 관리한다 | 패키지 관리, 릴리스 |
| 관찰 | 운영 로그와 리뷰에서 배운 것을 컨텍스트로 되돌린다 | 모니터링, 포스트모템 |
생성: 사람은 큐레이터가 된다
매번 Claude Code에 지시를 직접 타이핑하는 사람을 발표자는 “human context generator”라고 부른다. 이 방식은 확장되지 않는다. 대신 컨텍스트가 여러 출처에서 들어오게 한다.
- 규칙과 지침:
AGENTS.md처럼 저장소에 두는 지침 파일 - 라이브러리 문서: 쓰는 라이브러리 버전에 맞는 문서를 가져다주는 도구들
- 다른 팀이 발행한 컨텍스트: 사내 서비스 팀이 자기 서비스 사용법을 컨텍스트로 제공
- 연결된 정보: MCP 커넥터로 Slack 같은 곳에서 결정의 배경을 찾아오기
- 명세(spec): 작업 명세나 제품 기능 명세를 프로젝트에 계속 두고 참조하기
그리고 사람의 역할은 “curator of context”로 바뀐다. 직접 쓰기보다 고르고, 다듬고, 승인한다. 링크드인이 “기계가 기본 프로필을 쓰고, 사람이 기계가 추론할 수 없는 것을 보탠다”고 한 구조와 같은 방향이다.
평가: 린팅에서 내 저장소의 테스트까지
발표에서 가장 실용적인 부분이다. 출발점은 SWE-bench 같은 코딩 벤치마크인데, 발표자는 청중 중 모델을 직접 만드는 사람은 “maybe 0.01%“일 거라고 했다. 나머지 대부분이 만드는 건 모델이 아니라 컨텍스트다. 그러니 평가할 대상도 컨텍스트다.
방법은 간단하다. 도커 컨테이너에서 코딩 에이전트를 돌리고, 테스트가 통과하는지 본다. 컨텍스트가 없을 때와 있을 때, 옛 버전과 새 버전을 비교한다. 평가는 네 단계로 올라간다.
| 단계 | 확인하는 것 |
|---|---|
| 1. 린팅 | 스킬 파일의 필수 항목, 문법, 설명 길이 같은 형식 |
| 2. LLM 심사 | 이 모델에 효과적인 문체인지, 너무 짧거나 뒤섞인 부분은 없는지. 발표자 표현으로 “Grammarly for context” |
| 3. 기능 평가 | 스킬이 목표 작업을 실제로 끝내는지, 고치면 결과가 나아지는지 |
| 4. 내 저장소의 E2E | 특정 커밋에서 시작해 프롬프트를 주고 작업이 끝났는지 테스트 |
4단계가 핵심이다. “the rubber meets the road if it’s within your repo. Otherwise, it’s like a synthetic check.” 벤더가 제공하는 평가 지표나 남이 만든 벤치마크로는 내 코드베이스에서 통하는지 알 수 없다.
테스트가 생기면 최적화도 할 수 있다. 모델이 이미 아는 내용은 효과 없이 창만 차지하니 지우고, 서로 충돌하는 지시를 찾아낸다. 에이전트가 잘못 동작한 사례는 회귀 테스트로 남긴다. 처음에는 로컬에서 테스트 두어 개로 빠르게 피드백을 받고, 나중에 범위를 넓혀 CI에 넣는다.
여기서 데이터를 다루는 사람에게 익숙한 문제가 나온다. 결과가 비결정적이다. 같은 컨텍스트로 같은 테스트를 돌려도 매번 결과가 다르다. 그래서 발표자는 같은 테스트를 예컨대 다섯 번 돌려 대체로 통과하는지 본다. 컨텍스트를 고치면 어떤 테스트는 통과하고 다른 테스트는 깨지는 일도 흔하다. 발표자는 이걸 “Whack-A-Mole”(두더지 잡기)이라고 불렀다. 그러면 누가 출시를 결정하나.
98% of my evals work, what do I do? Who decides?
발표자의 답은 SRE의 error budget처럼 평가를 나누는 것이다. 반드시 통과해야 하는 평가와 조금 흔들려도 되는 평가를 구분하고, 그 경계에서는 제품 책임자가 위험을 판단한다. 이건 A/B 테스트의 가드레일 지표와 같은 구조다. 주요 지표가 좋아져도 가드레일이 정해 둔 선 아래로 떨어지면 출시하지 않는다. 몇 번 돌려야 “대체로 통과”를 믿을 수 있는지는 검정력 분석의 질문이기도 하다. 발표자가 아직 풀리지 않은 문제로 꼽은 것 중 하나가 바로 컨텍스트 A/B 테스트, 즉 두 팀에 새 컨텍스트를 먼저 시험하고 확대하는 방식이었다. 그런 제품은 아직 못 찾았다고 했다.
배포와 관찰: 패키지로 나누고, 운영에서 배운다
배포. 컨텍스트를 저장소에 체크인하면 프로젝트를 받는 사람이 컨텍스트도 같이 받는다. 하지만 한 저장소에 다 몰아넣으면 다른 프로젝트에서 재사용하기 어렵다. 그래서 발표자는 패키지를 제안한다. npm 패키지처럼 “이 프로젝트에 이 컨텍스트의 이 버전을 설치”하고 업데이트한다. 그 포맷으로는 스킬이 자리 잡고 있다. “skills is a little bit on its way to become the standard JAR, npm package, or whatever of context.” 지침 파일은 AGENTS.md가 표준이 되어 가는 중이다.
패키지가 되면 소프트웨어 공급망의 문제도 같이 따라온다.
- 소유권: 공유 지침과 스킬에도 그걸 가장 잘 아는 팀이 주인으로 있어야 한다. 누구나 규칙을 제안할 수 있지만 전사 배포는 몇 사람이 승인하는 식이다.
- 보안 검사: 스킬에는 코드도 들어갈 수 있으니 악성 스킬을 걸러야 한다.
- 출처 추적: 누가, 언제, 왜 만든 컨텍스트인지, 어느 줄을 AI가 썼는지 남긴다.
- 레지스트리만으로는 부족하다: 마켓플레이스의 개인 스킬은 테스트가 없는 경우가 많아서, 내 코드베이스에서 어떻게 동작할지 알 수 없다.
관찰. 마지막 단계는 운영에서 배운 것을 컨텍스트로 되돌리는 것이다.
- 에이전트의 회고: Hugging Face는 에이전트에게 작업이 끝나면 회고(retrospective)를 쓰게 하고, 그 결과로 지침을 고친다. 고친 컨텍스트를 다시 패키지로 올리면 다른 에이전트도 다음 실행부터 받는다.
- 리뷰와 대화: “Every commit is a story.” 에이전트 커밋에 달린 리뷰 코멘트와 배포 후 Slack 피드백이 컨텍스트가 실전에서 통했는지 알려준다.
- 운영 정보: 장애가 나면 영향받은 코드와 사용량 정보를 티켓 대신 교훈으로 컨텍스트에 남긴다.
- 컨텍스트 방화벽: 에이전트가 시작할 때 디스크에서 어떤 지침 파일을 읽어 들이는지 가로채 검사하는 실험도 소개했다. 차단하지 않고 기록만 해도 피드백이 된다.
그리고 이 네 단계가 개인에서 동료로, 팀으로 넓어지면 컨텍스트 플라이휠이 된다. 한 사람이 배운 것이 검증된 컨텍스트가 되어 다른 사람과 다른 에이전트에게 퍼진다. 발표자의 마지막 문장이 이걸 요약한다. “context is the fuel, and coding agents are your engine.”
세 글을 잇는 그림
지금까지의 세 글을 한 장으로 정리하면 이렇다.
| 글 | 질문 | 비유 |
|---|---|---|
| 컨텍스트 엔지니어링 | 지금 이 작업에 창 안에 무엇을 넣을까 | 함수 하나를 잘 짜기 |
| 링크드인 데이터 컨텍스트 레이어 | 회사의 데이터 지식을 어디에 모아 어떻게 서빙할까 | 공용 라이브러리와 저장소 |
| 컨텍스트도 코드처럼 (이 글) | 그 지식을 어떻게 바꾸고, 검증하고, 배포하고, 개선할까 | CI/CD와 운영 |
세 글에 공통으로 나오는 원칙이 있다. 컨텍스트는 Git에 두고, 사람이 리뷰하고, 한 곳에서 관리한다. 링크드인과 핀터레스트는 데이터 지식을, 이 발표는 코딩 에이전트의 지침을 다루지만 결론은 같다.
솔직하게 이 블로그의 경우를 보면, 절반쯤 와 있다. 매일 아침 글감을 모아 디스코드로 보내는 에이전트의 지침(prompt.md)은 Git에 있고, 고친 뒤 설치 스크립트로 배포하고, 날짜별 결과 파일과 로그가 남는다. 생성, 배포, 관찰의 뼈대는 있다. 비어 있는 건 평가다. 지침을 고쳤을 때 브리핑이 더 좋아졌는지 확인하는 테스트가 없다. 지금은 결과를 눈으로 보고 판단한다.
마치며: 작은 팀이 바로 해볼 것
- 지침 파일을 저장소에 넣고 리뷰를 거치게 한다.
AGENTS.md나CLAUDE.md를 바꾸는 PR도 코드 PR처럼 본다. 이것만으로 “누가 언제 왜 바꿨나”가 남는다. - 에이전트가 실수한 사례를 테스트로 남긴다. 거창한 벤치마크가 아니어도 된다. “이 커밋에서 이 프롬프트를 주면 이 테스트가 통과해야 한다”는 케이스 두세 개면 시작할 수 있다.
- 한 번이 아니라 여러 번 돌려 본다. 결과가 비결정적이니 한 번 통과는 아무것도 증명하지 않는다. 다섯 번 중 몇 번 통과하는지를 본다.
- 꼭 통과해야 하는 것과 흔들려도 되는 것을 나눈다. 보안이나 데이터 삭제처럼 절대 깨지면 안 되는 평가는 하나라도 실패하면 배포하지 않는다.
- 모델이 이미 아는 건 지운다. 지침이 길어질수록 좋은 게 아니다. 테스트가 있으면 무엇을 지워도 되는지 확인할 수 있다.
- 문제가 생기면 먼저 묻는다. “컨텍스트를 업데이트했나?” 발표자가 권한 습관이다. 같은 실수가 두 번 나오면, 그건 에이전트가 아니라 컨텍스트의 버그다.