표본이 충분하지 않을 때 실험은 어떻게 해야 할까?
A/B 테스트 표본이 부족할 때 쓸 방법을 논문과 기업 사례 수치로 정리했습니다. 큰 변경, 지표 손질과 CUPED, 인터리빙, 판단 기준 조정, 실험 밖 대안까지 순서대로 다룹니다.
목차
들어가며
결론부터: A/B 테스트 표본이 부족하면 표본을 늘리려 애쓰기보다 설계를 바꿔야 한다. 바꿀 수 있는 것은 네 가지다. 효과를 키우거나, 노이즈를 줄이거나, 판단 방식을 바꾸거나, 실험 밖에서 답을 찾는 것이다.
A/B 테스트에서 검정력 분석이 필요한 이유의 마지막 부분에서 “표본을 충분히 확보하지 못할 때” 쓸 수 있는 방법 7가지를 한 줄씩 적었다. 이 글은 그 후속이다. 방법마다 원리, 실제로 표본을 얼마나 아끼는지(논문과 기업 기술 블로그의 수치), 언제 통하지 않는지를 정리했다.
조사하면서 눈에 띈 점이 하나 있다. 한국어 검색 결과에는 “표본 크기 계산” 글은 많지만 “부족할 때 어떻게 하나”를 다룬 글은 드물고, CUPED나 인터리빙을 실제로 적용한 수치를 공개한 국내 기업 글은 찾지 못했다. 그래서 수치는 대부분 마이크로소프트, 넷플릭스, 스포티파이 같은 해외 자료에서 가져왔다.
먼저: 지금 트래픽으로 무엇을 잡을 수 있나
표본 수 공식을 뒤집으면, 가진 트래픽으로 탐지할 수 있는 최소 효과(MDE)가 나온다. 실험을 설계하기 전에 이것부터 계산한다.
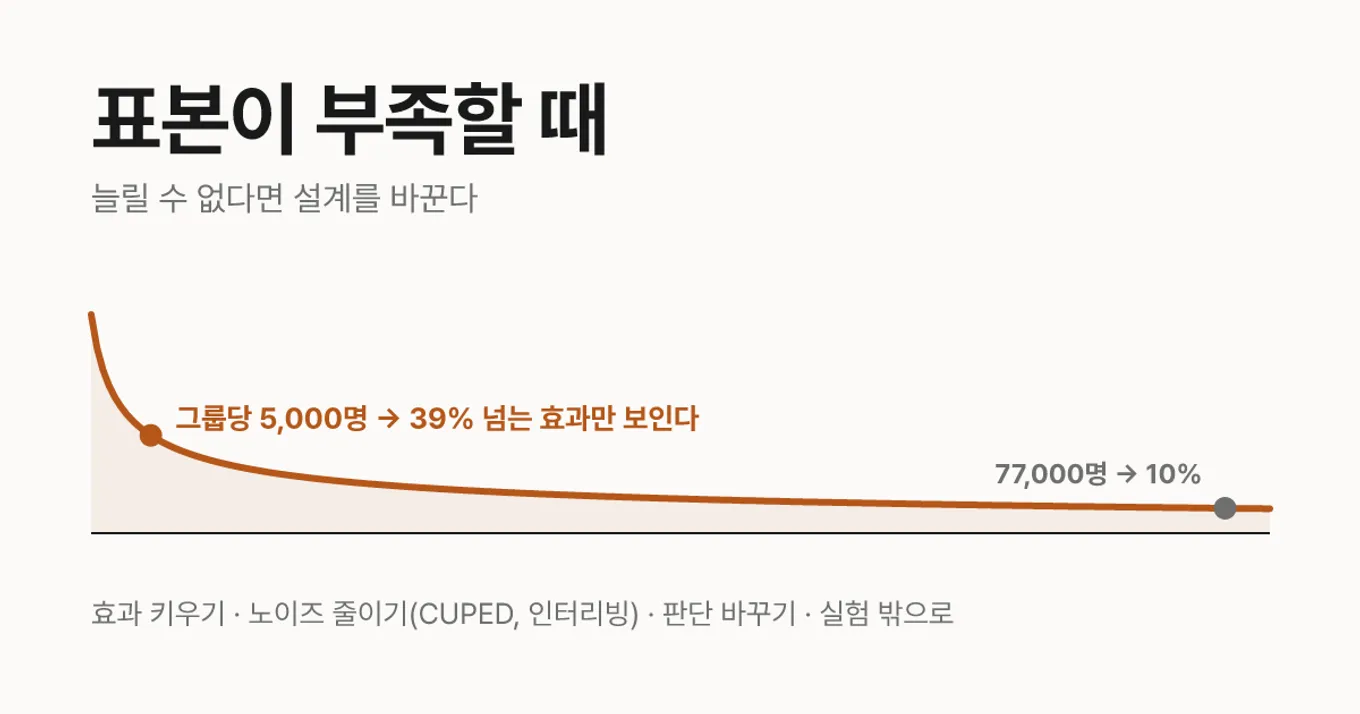
MDE(절대 차이) ≈ (z₁₋α/₂ + z₁₋β) × √(2σ² / n) ≈ 2.8 × √(2σ² / n) (α = 0.05 양측, 검정력 0.8)기준 전환율 2.0%에서 그룹당 표본 수별로 계산하면 이렇다.
그룹당 5,000명을 모을 수 있는 서비스라면, 전환율을 39% 넘게 올리는 변경이 아니면 이 실험으로는 판단할 수 없다는 뜻이다.
예시: 하루 방문자 2,000명인 쇼핑몰 (이해를 돕기 위한 가상의 예시다. 이 글 끝까지 이 쇼핑몰을 따라간다.)
작은 패션 쇼핑몰의 마케터가 상품 상세 페이지의 배송 안내를 “무료배송”으로 크게 강조하는 실험을 하려 한다. 하루 방문자는 2,000명, 구매 전환율은 2.0%, 기대하는 효과는 상대 +5%다.
- 4주 동안 돌리면 그룹당 28,000명이 모인다. 이때 MDE는 약 **16.6%**다.
- +5%를 잡으려면 그룹당 약 31만 명, 지금 트래픽으로 약 44주가 필요하다.
이 설계로는 결론이 나지 않는다. 4주 뒤 “유의하지 않음”이 나오거나, 운 좋게 유의하게 나와도 그 효과는 크게 부풀려져 있을 것이다. 이 쇼핑몰이 단계마다 무엇을 할 수 있는지 아래에서 이어서 본다.
그래도 일단 돌려 보면 안 되나? 검정력이 낮은 실험은 “효과를 놓치는” 데서 끝나지 않는다. 유의하게 나온 결과 자체를 믿기 어려워진다. Kohavi, Deng, Vermeer(2022)는 아이디어 성공률이 10% 수준인 조직(부킹닷컴, 구글 광고, 넷플릭스가 이 정도라고 한다)에서 유의한 결과 중 거짓 양성의 비율을 이렇게 계산했다.
| 검정력 | 80% | 50% | 20% |
|---|---|---|---|
| 유의한 결과 중 거짓 양성 | 22.0% | 31.0% | 52.9% |
(단측 α = 0.025 기준.) 검정력 20%로 실험하면 “유의하게 이겼다”는 결과의 절반 이상이 가짜다. 논문에는 사용자 약 80명으로 돌린 실험의 검정력이 3%였고 거짓 양성 비율이 63%였던 실제 사례도 나온다. 살아남은 결과의 효과 크기가 부풀려지는 Type M 오류는 검정력 분석 글에서 다뤘다.
최소 몇 명이면 실험할 수 있나? Kohavi의 경험칙은 “적어도 수천 명의 활성 사용자, 가능하면 수만 명”이다. 강연에서는 “20만 명”이라는 숫자도 쓰는데, 이는 전환율 5%에서 상대 5%의 작은 효과를 잡는 조건(그룹당 121,600명)이다. 두 숫자가 모순되는 것이 아니라 전제한 MDE가 다르다. 작은 효과를 잡으려면 수십만 명, 큰 효과만 보려면 수천 명이다.
1. 효과를 키운다
필요한 표본 수는 효과 크기의 제곱에 반비례한다. 효과를 2배로 키우면 표본은 4분의 1로 줄고, 반대로 Kohavi 등(2013)의 표현대로 민감도를 10배 높이려면(5% → 0.5%) 사용자가 100배 필요하다. 그래서 표본이 적을 때 가장 강력한 수단은 통계 기법이 아니라 실험 대상을 고르는 일이다.
- 큰 변경을 실험한다: 버튼 색 대신 가격 구조, 온보딩 흐름, 핵심 기능처럼 지표를 크게 움직일 수 있는 변경을 고른다. 작은 개선은 묶어서 한 번에 실험하거나, 실험 없이 배포한다.
- 변형 수를 줄인다: A/B/C/D 실험은 같은 트래픽을 넷으로 나눈다. 표본이 부족하면 대조군과 가장 유력한 안 하나만 비교한다.
- 트래픽을 반반으로 나눈다: 위험을 줄이려고 실험군을 10%만 두면 같은 검정력에 더 많은 표본이 든다. LINE 오픈챗 팀은 실험군 비율을 50%에서 10%로 줄이면 필요한 표본이 약 3배까지 늘어난다고 계산했다. 표본이 부족하다면 50:50이 기본이다.
- 동시 실험끼리 트래픽을 쪼개지 않는다: 실험 간 간섭을 막으려고 사용자를 실험별로 나누면, 실험 하나가 쓰는 표본이 그만큼 준다. 당근은 “슬롯을 10개 실험이 나눠 쓰면 한 실험의 표본 수는 전체의 약 10분의 1이 돼요”라고 설명한다. 우아한형제들 실험 플랫폼 글도 “충분한 모수가 확보되지 않은 경우라면 충돌을 감수하더라도 전체 범위를 지정하는게 더 나은 판단일 수 있습니다”라고 권한다.
- 효과가 일어나는 사람만 분석한다: 변경을 실제로 본 사용자만 분석 대상에 넣는다(트리거 분석). 변경을 보지 못한 사용자는 효과가 0인데 분산만 보탠다. 당근 실험 플랫폼도 트리거 기반 분석을 지원한다. 배민의 최소주문금액바 실험이 반대 사례다. 효과가 없었던 이유를 팀은 “커머스 전체 지표를 움직일 만큼 혜택이 노출되지 않았던 거죠”라고 정리했다.
예시로 보면: 쇼핑몰은 배송 문구 강조 대신 무료배송 기준 금액을 5만 원에서 3만 원으로 낮추는 실험을 고른다. 문구는 눈에 띄게 할 뿐이지만, 기준 금액은 구매 결정에 직접 닿는다. 과거 프로모션 데이터로 +20% 정도를 기대할 근거가 있다면 그룹당 약 19,000명, 3주 안에 결론이 난다. 배송 문구 강조는 되돌리기 쉬운 작은 변경이니 실험 없이 배포하고 지표를 지켜본다.
주의: “큰 효과를 기대한다”와 “실제로 효과가 크다”는 다르다. 기대만 크고 실제 효과가 작으면 검정력은 여전히 낮고, 그 상태에서 나온 유의한 결과는 부풀려져 있다. 기대 효과는 바람이 아니라 과거 실험이나 근거로 잡는다.
2. 노이즈를 줄인다
효과를 키울 수 없다면 분모인 분산을 줄인다. 같은 표본으로 더 작은 효과를 잡을 수 있다.
지표를 손본다: 과거 데이터 없이 바로 할 수 있는 것
| 방법 | 원리 | 수치 |
|---|---|---|
| 상한 두기(capping) | 매출처럼 꼬리가 긴 지표에서 극단값을 잘라 분산을 줄인다 | 사용자당 매출을 주당 $10로 자르자 같은 표본으로 30% 더 작은 변화를 잡았고, 필요 표본이 114k에서 9.7k로 줄었다 (Kohavi 등, 2014) |
| 횟수 → 비율·이진 | “클릭 수” 대신 “클릭률”, “세션 수” 대신 “재방문 여부”처럼 0~1로 묶인 지표를 쓴다 | 쿼리 클릭 수를 쿼리 클릭률로 바꾸자 민감도가 크게 올랐다 (Dmitriev & Wu, 2016) |
| 퍼널 상단 지표 | 드문 최종 전환 대신 자주 일어나는 앞 단계 행동을 주요 지표로 둔다 | Yandex의 A/B 테스트 32개에서 유의하게 나온 개수: 사용자당 세션 2개, 클릭 8개, 쿼리당 클릭 15개 (Drutsa 등, 2015) |
어디서 자를지는 지표마다 정한다. 참고로 실험 플랫폼 Statsig는 기본값으로 99.9 백분위에서 자른다.
함정: 민감한 지표는 쉽게 움직이는 만큼 엉뚱하게도 움직인다. 클릭은 페이지 안에서 자리만 옮겨도 오르고, 클릭률이 오른 변경이 리텐션을 떨어뜨리기도 한다. 퍼널 상단 지표를 주요 지표로 쓴다면 최종 전환이나 매출을 가드레일 지표로 함께 둔다.
예시로 보면: 쇼핑몰이 주요 지표를 구매 전환율(2.0%) 대신 장바구니 담기율(8.0%)로 바꾸면, 같은 4주, 그룹당 28,000명으로 MDE가 16.6%에서 **8.0%**로 내려간다. 사건이 4배 자주 일어나니 같은 표본으로 절반 크기의 효과를 볼 수 있다. 대신 구매 전환율과 객단가를 가드레일로 둔다. 장바구니에 담기만 하고 사지 않는 변화를 “개선”으로 착각하지 않기 위해서다.
과거 실험이 수백 건 쌓인 회사라면 장기 지표를 예측하는 대리 지표(surrogate)를 학습해 쓰기도 한다. 구글은 대리 지표가 원래 지표보다 8.5배 민감했다고 보고했다. 하지만 학습에 필요한 실험 수를 생각하면 표본이 부족한 조직이 쓸 방법은 아니다.
CUPED: 실험 전 데이터로 분산을 덜어낸다
CUPED(Controlled-experiment Using Pre-Experiment Data)는 실험 전 기간의 같은 지표로 실험 지표를 보정한다. 원래 활동이 많던 사용자는 실험 기간에도 활동이 많다. 그 몫을 빼면 실험 처치 때문에 생긴 차이만 남는다.
Y_cuped = Y − θ × (X − X̄), θ = cov(Y, X) / var(X)var(Y_cuped) = var(Y) × (1 − ρ²)ρ: 실험 전 지표 X와 실험 지표 Y의 상관분산은 상관의 제곱만큼 준다. 필요한 표본도 같은 비율로 준다.
| 상관 ρ | 0.3 | 0.5 | 0.7 | 0.9 |
|---|---|---|---|---|
| 분산(= 필요 표본) 감소 | 9% | 25% | 49% | 81% |
실제 효과: 마이크로소프트 Bing에서는 분산이 약 50% 줄었다(실험 세 건에서 45%, 52%, 49%). 사용자 절반으로, 또는 기간 절반으로 같은 검정력을 얻었다는 뜻이다(Deng 등, 2013). 넷플릭스는 기존 사용자에서 최대 40%를 보고했다(Xie & Aurisset, 2016).
안 통하는 경우: 실험 전 데이터가 없거나 상관이 약할 때다.
- 신규 사용자: 실험 전 기록이 없다. 넷플릭스도 신규 사용자에서는 지표와 관계없이 분산 감소가 “매우 낮았다”.
- 매출 지표: Bing에서 사용자당 매출은 상관이 낮아 분산이 5%도 줄지 않았다.
- 대부분의 지표: 마이크로소프트 ExP 팀은 한 제품에서 지표의 68% 이상이 CUPED로 얻은 실효 트래픽 증가가 1.05배 이하였다고 밝혔다.
- 국내 실패 사례: 한 국내 분석가는 사전 기록이 있는 사용자가 12%뿐이고 상관이 0.31이라 기대 효과가 약 10%에 그쳤다는 경험을 공유했다(찬비, 2026). 기록이 있는 사용자 비율과 그 사용자들의 상관 중 하나만 낮아도 효과가 크게 떨어진다.
예시로 보면: 쇼핑몰 방문자 중 지난달 기록이 있는 재방문 고객이 30%이고, 이들의 지난달과 이번 달 구매 여부 상관이 0.5라고 하자. 어림하면 전체 분산은 0.3 × 0.5² ≈ 7.5% 주는 데 그치고, MDE는 16.6%에서 약 15.9%로 내려갈 뿐이다. 이 쇼핑몰에게 CUPED는 1순위가 아니다.
그래서 CUPED는 재방문 사용자가 많은 서비스에서, 재방문 행동을 지표로 삼을 때 가장 잘 통한다. 적용 전에 과거 데이터로 ρ부터 계산해 보면 기대 효과를 미리 알 수 있다. 실험 전 지표 대신 머신러닝 모델의 예측값을 쓰는 CUPAC(DoorDash)도 있지만, 모델에 처치의 영향을 받는 변수를 넣으면 안 된다.
설계를 바꾼다
| 방법 | 표본 절감 | 쓸 수 있는 곳 | 한계 |
|---|---|---|---|
| 인터리빙 | 넷플릭스: 95% 검정력에 가장 민감한 A/B 지표보다 100배 넘게 적은 사용자. 에어비앤비: 같은 트래픽으로 50배 빠름 | 검색, 추천, 랭킹 | 두 랭커 중 무엇을 더 선호하는지만 알려 준다. 리텐션 같은 지표는 못 잰다 |
| 더 작은 무작위화 단위 | 사용자 대신 페이지 단위로 나누면 페이지 단위 지표 분산이 7배 감소(시뮬레이션, Deng 등 2011) | 사용자가 매번 다른 버전을 봐도 괜찮은 변경 | 사용자 단위 지표(리텐션 등)는 쓸 수 없다 |
| 교차 설계 | 같은 사용자가 기간을 나눠 두 버전을 모두 경험. 병렬 설계 대비 약 50% 감소 (Guo & Deng, 2015) | 효과가 바로 나타나고 사라지는 변경 | 앞 기간의 경험이 뒤 기간에 남으면 안 된다 |
인터리빙은 한 사용자에게 랭커 A와 B의 결과를 섞은 목록 하나를 보여 주고, 어느 쪽 결과를 더 클릭하는지 본다. 사용자가 자기 자신의 대조군이 되니 사용자 간 차이라는 노이즈가 사라진다. 넷플릭스와 에어비앤비는 인터리빙으로 후보를 며칠 만에 추린 뒤 남은 후보만 A/B 테스트로 확인한다. 에어비앤비에서 인터리빙과 A/B 결과의 방향이 같았던 비율은 82%였다.
3. 판단 방식을 바꾼다
효과도 노이즈도 손볼 수 없다면 남은 것은 “무엇을 보고 결정할지”다. 여기서는 표본이 늘지 않는다. 대신 틀릴 위험을 어떻게 나눌지를 바꾼다. 그래서 모든 선택은 실험 전에 문서로 남겨야 한다.
유의수준을 완화한다: 되돌리기 쉬운 결정에만
α = 0.05는 법칙이 아니라 관습이다. Azevedo 등(2020)은 Bing 실험 데이터를 분석해, 대부분의 이득이 소수의 대박 아이디어에서 나오는 환경이라면 아이디어 하나에 큰 표본을 쓰기보다 작은 표본으로 많은 아이디어를 시험하는 편이 낫다고 보였다. 실제로 상위 2%의 아이디어가 과거 이득의 74.8%를 냈다. 배포를 되돌리기 쉽다면 α를 0.1까지 올려도 된다는 주장도 이런 근거에서 나온다.
대가도 수치로 알고 있어야 한다. α를 0.10으로 올리면 성공률 10%인 조직에서 유의한 결과 중 거짓 양성이 36%까지 오른다(Kohavi, 2022 강연). Optimizely 고객 실험 2,766개를 분석한 연구에서는 10% 유의수준에서 거짓 발견률이 28~37%였는데, 원인은 검정력보다 효과가 실제로 없는 실험이 약 70%라는 데 있었다(Berman & Van den Bulte, 2022). Kohavi는 위험과 속도를 함께 고려해도 “0.05가 합리적인 기본값”이라고 본다.
정리하면 α 완화는 이런 경우에만 쓴다.
- 되돌리기 쉽고, 잘못 배포해도 손실이 작은 변경이다.
- 실험 전에 α를 정하고 문서로 남긴다.
- 결과를 보고할 때 “α = 0.1이었으니 이 정도 거짓 양성 위험이 있다”를 함께 적는다.
예시로 보면: 쇼핑몰이 α를 0.05에서 0.1로 올려도 4주 실험의 MDE는 16.6%에서 14.7%로 내려갈 뿐이다. 거짓 양성 위험은 두 배로 늘었는데 얻는 것은 작다. 표본이 이 정도로 부족하면 α 완화는 근본 해결이 아니다.
국내 글에서 보이는 “B가 나을 확률이 70~90%면 일부만 배포한다”는 접근도 사실상 같은 선택이다. 뒤에서 보듯 평평한 사전분포라면 단측 우월 확률 90%는 단측 p = 0.1과 같다.
표본을 이익 기준으로 정한다: Test & Roll
이메일 캠페인처럼 대상 전체가 정해져 있다면, 일부에게 실험하고 나머지에게 승자를 배포하는 구조가 된다. Feit & Berman(2019)은 이때 표본 크기를 검정력이 아니라 기대 이익을 최대로 하는 값으로 정하자고 제안했다. 전체 10만 명 예시에서 가설검정 기준은 그룹당 18,468명이 필요했지만, 이익 기준(Test & Roll)으로는 그룹당 2,284명이면 됐다. 대가는 더 나쁜 안을 배포할 확률 10%다. 틀려도 손해가 작고, “어느 쪽이 나은가”보다 “남은 사람에게 무엇을 보낼까”가 목적이라면 합리적인 선택이다.
예시의 쇼핑몰이 회원 2만 명에게 쿠폰 문자를 보낸다면 이 구조가 맞는다. 두 문구를 각각 수백 명에게 먼저 보내고, 반응이 나은 쪽을 나머지에게 보낸다. 여기서 목표는 “문구 A가 B보다 낫다는 지식”이 아니라 이번 캠페인의 매출이다.
중간에 볼 거라면 순차 검정
표본이 적은 팀일수록 결과를 자주 들여다보고 싶어진다. 그런데 정해 둔 표본에 도달하기 전에 볼 때마다 유의성을 확인하면 거짓 양성이 급격히 는다. 매 관측마다 확인하면 실제 유의수준은 5%가 아니라 26.1%가 된다(Evan Miller).
순차 검정은 중간에 봐도 오류율이 유지되도록 문턱을 조정한다. 효과가 크면 일찍 끝낼 수 있어서 일부 상황에서는 표본을 50% 넘게 아낀다. 하지만 효과가 없을 때는 고정 표본 검정보다 오히려 늦게 끝난다. 그래서 순차 검정은 표본을 줄이는 도구라기보다 안전하게 들여다보는 도구로 보는 것이 정확하다. 스포티파이는 최대 표본 수를 정할 수 있으면 그룹 순차 검정(GST)이 검정력이 가장 높고, 확인 횟수가 몇 번뿐이라면 일반 z 검정에 본페로니 보정만 해도 충분하다고 정리했다.
베이지안은 표본을 만들어 주지 않는다
“베이지안 A/B 테스트는 표본이 적어도 된다”는 말을 자주 듣는다. 스포티파이가 2026년 9월에 정리한 결론은 다르다.
- 평평한 사전분포(flat prior)에서 단측 “B가 A보다 나을 확률”은 1 − p와 같다. 숫자만 바뀌었을 뿐 정보는 같다.
- 평평한 사전분포에서 사후확률이 문턱을 넘으면 멈추는 방식은 빈도주의 peeking과 같은 거짓 양성 비율을 만든다. 대부분의 플랫폼이 기본으로 제공하는 방식이다.
- 과거 실험으로 사전분포를 만들려면 대표성 있는 실험이 200건 넘게 필요하다. 이미 이긴 실험만 모으면 오히려 나빠진다. 가장 이상적인 사전분포를 써도 GST보다 검정력이 높지 않았다.
베이지안 접근의 진짜 장점은 표본 절약이 아니라 결정의 비용을 드러내는 데 있다. “B를 배포했을 때 예상되는 손실이 0.1%p보다 작으면 배포한다” 같은 기대 손실 기준은, 효과 없는 안을 배포해도 비용이 거의 없는 상황에서는 합리적인 규칙이다. 다만 그 규칙은 “유의하다”가 아니라 “틀려도 손해가 작다”를 말하는 것이므로, 보고할 때도 그렇게 적는다.
밴딧은 짧은 캠페인에만
멀티암드 밴딧은 실험 중에 더 나은 안으로 트래픽을 옮겨 손실을 줄인다. 대신 A/B 테스트보다 승자와 패자를 가리는 데 오래 걸리고, 통계적 유의성을 내지 않는다(Optimizely). 헤드라인 테스트나 연휴 세일처럼 짧게 쓰고 끝나는 경험에서 “지금 가장 잘 되는 것”을 고르는 데 적합하다. 국내에서도 카카오와 무신사가 추천과 정렬에 톰슨 샘플링을 쓴다. 다만 이는 배우기보다 최적화하는 도구다. “이 기능이 효과가 있는가”를 알고 싶다면 밴딧은 답이 아니다.
4. 실험 밖에서 답을 찾는다
여기까지 해도 안 되면 A/B 테스트를 고집할 이유가 없다. 그만큼의 트래픽을 기다리는 동안 시즌과 상품이 바뀌기 때문이다.
- 정성 리서치: 닐슨 노먼 그룹의 유명한 결론은 사용자 5명이면 사용성 문제의 85%를 찾는다는 것이다. 다만 이 숫자는 “문제를 찾는 비율”이지 전환율 효과를 추정한 것이 아니다. 같은 글에서도 5명씩 세 번 나눠 하라고 권한다. “왜 이탈하나”는 정성으로, “얼마나 오르나”는 나중에 트래픽이 생기면 실험으로 답한다.
- 예시로 보면: 쇼핑몰은 배송 문구를 실험하는 대신 고객 5명에게 상세 페이지를 보여 주고 배송비와 무료배송 조건을 찾아보게 한다. 5명 중 3명이 조건을 못 찾는다면, 문구 강조보다 정보 위치를 옮기는 게 먼저라는 답이 실험 없이 나온다.
- 준실험과 전후 비교: 지역이나 기간 단위로 개입을 켰다 껐다 반복하면, 단위 수가 적어도 꽤 정밀하게 효과를 추정할 수 있다(넷플릭스). 다만 관찰 데이터로 추정한 효과는 무작위 실험 결과를 자주 재현하지 못한다. Facebook 광고 실험 15건을 비교한 연구가 대표적이다. 이중차분법 같은 방법은 데이터 분석가 책 추천에서 소개한 『실무로 통하는 인과추론 with 파이썬』이 잘 다룬다.
- 실험을 쌓는다: 스포티파이는 실험의 승률은 약 12%지만, 무언가를 배운 실험의 비율(학습률)은 약 64%라고 보고했다. 표본이 부족한 시기에도 가설, 설계, 결과를 기록해 두면, 트래픽이 생겼을 때 무엇을 먼저 실험할지와 기대 효과를 근거로 잡을 수 있다.
마치며: 표본이 부족할 때 순서
| 순서 | 할 일 | 기대 효과 | 전제 |
|---|---|---|---|
| 1 | 지금 트래픽으로 MDE를 역산한다 | 이 실험이 의미 있는지 미리 안다 | 기준 지표와 분산 |
| 2 | 큰 변경을 고르고, 변형을 줄이고, 노출된 사용자만 분석한다 | 효과 2배 = 표본 4분의 1 | 근거 있는 기대 효과 |
| 3 | 지표를 손본다 (capping, 비율·이진, 퍼널 상단) | capping 하나로 필요 표본 114k → 9.7k 사례 | 가드레일 지표 병행 |
| 4 | CUPED를 적용한다 | 분산 최대 약 50% 감소 | 재방문 사용자, 실험 전 지표와 상관 |
| 5 | 랭킹·추천이면 인터리빙을 쓴다 | 50~100배 이상 빠름 | 섞을 수 있는 목록 |
| 6 | 판단 기준(α, 순차 검정, 기대 손실)을 실험 전에 정한다 | 표본은 그대로, 위험 배분을 명시 | 되돌리기 쉬운 결정 |
| 7 | 실험 밖에서 답을 찾는다 | 기다리는 비용 제거 | 인과 추정의 한계를 인정 |
예시의 쇼핑몰(하루 방문자 2,000명, 구매 전환율 2.0%, 4주)에 적용한 결과를 모으면 이렇다.
| 선택 | 결과 |
|---|---|
| 원래 설계 (배송 문구 강조, 구매 전환율, α 0.05) | MDE 16.6%, 기대한 +5%를 확인하려면 약 44주 |
| 무료배송 기준 금액 변경 (기대 +20%) | 그룹당 약 19,000명, 3주 안에 결론 |
| 주요 지표를 장바구니 담기율로 | MDE 8.0% (구매 전환율은 가드레일) |
| CUPED (재방문 30%, 상관 0.5) | MDE 약 15.9%, 효과 작음 |
| α 0.1로 완화 | MDE 14.7%, 거짓 양성 위험은 2배 |
| 5명 사용성 테스트 | 실험 없이 배송 정보 위치 문제를 발견 |
효과를 키우고 지표를 바꾸는 것이 가장 크게 움직이고, 통계 기법(CUPED, α 완화)은 이 규모에서 거의 도움이 되지 않는다. 표본이 적을수록 무엇을 실험할지가 어떻게 분석할지보다 중요하다.
앞의 방법일수록 부작용이 적다. 13번은 어떤 팀이든 오늘 할 수 있고, 45번은 데이터와 문제 유형이 맞아야 하며, 6번은 위험을 감수하는 선택이다. 그리고 어느 방법을 쓰든 바뀌지 않는 원칙이 하나 있다. 표본이 적을수록 “유의하다”는 결과를 더 의심해야 한다.
참고 자료
- Kohavi, R., Deng, A., & Vermeer, L. (2022). A/B Testing Intuition Busters. KDD.
- Kohavi, R., Deng, A., Frasca, B., Walker, T., Xu, Y., & Pohlmann, N. (2013). Online Controlled Experiments at Large Scale. KDD.
- Kohavi, R., Deng, A., Longbotham, R., & Xu, Y. (2014). Seven Rules of Thumb for Web Site Experimenters. KDD.
- Deng, A., Xu, Y., Kohavi, R., & Walker, T. (2013). Improving the Sensitivity of Online Controlled Experiments by Utilizing Pre-Experiment Data. WSDM.
- Xie, H., & Aurisset, J. (2016). Improving the Sensitivity of Online Controlled Experiments: Case Studies at Netflix. KDD.
- Microsoft ExP. Deep dive into variance reduction.
- Dmitriev, P., & Wu, X. (2016). Measuring Metrics. CIKM.
- Drutsa, A., Gusev, G., & Serdyukov, P. (2015). Future User Engagement Prediction and Its Application to Improve the Sensitivity of Online Experiments. WWW.
- Netflix Technology Blog. Interleaving in Online Experiments at Netflix.
- Airbnb Engineering (2022). Beyond A/B Test: Speeding up Airbnb Search Ranking Experimentation through Interleaving.
- Azevedo, E. M., Deng, A., Montiel Olea, J. L., Rao, J., & Weyl, E. G. (2020). A/B Testing with Fat Tails. Journal of Political Economy.
- Berman, R., & Van den Bulte, C. (2022). False Discovery in A/B Testing. Management Science.
- Feit, E. M., & Berman, R. (2019). Test & Roll: Profit-Maximizing A/B Tests. Marketing Science.
- Evan Miller. How Not To Run an A/B Test, Simple Sequential A/B Testing.
- Spotify Engineering (2023). Choosing a Sequential Testing Framework.
- Spotify Engineering (2026). Why Spotify Is Not Using Bayesian A/B Testing.
- Optimizely 지원 문서. Multi-armed bandit 최적화.
- Nielsen, J. (2000). Why You Only Need to Test with 5 Users. Nielsen Norman Group.
- 찬비 (2026). A/B 테스트: CUPED를 써봤는데 효과가 없었다. 브런치.
- 당근 (2023). 100+ 팀원의 의사결정에 영향을 주는 Data Scientist, Decision : 실험플랫폼.
- 당근 (2026). 실험을 더 편하게 설계할 수 있게: 당근 실험플랫폼 이야기.
- 우아한형제들 (2023). 실험과 기능플래그를 위한 실험플랫폼 구축하기.
- LY Corporation (2023). 오프라인과 온라인 A/B 테스트를 통해 오픈챗 추천 모델 개선하기.
- 우아한형제들 (2026). 한 번 성공하니 다음도 쉬울 줄 알았다: 최소주문금액바 4번의 A/B실험.